Template ฟรีบน RunPod · ทำรูปและคลิป AI ด้วย GPU แรงสุด
เช่า GPU เป็นชั่วโมง กดปุ่มเดียว
ได้ ComfyUI พร้อมทำรูปและคลิป
RTX PRO 6000 ชั่วโมงละราว 70 บาท ไม่ต้องติดตั้งอะไรเอง กรอกฟอร์มภาษาไทยใน Dashboard แล้วกดสร้าง ใช้เสร็จก็ปิดเครื่อง จ่ายเฉพาะเวลาที่เปิดจริง
Deploy
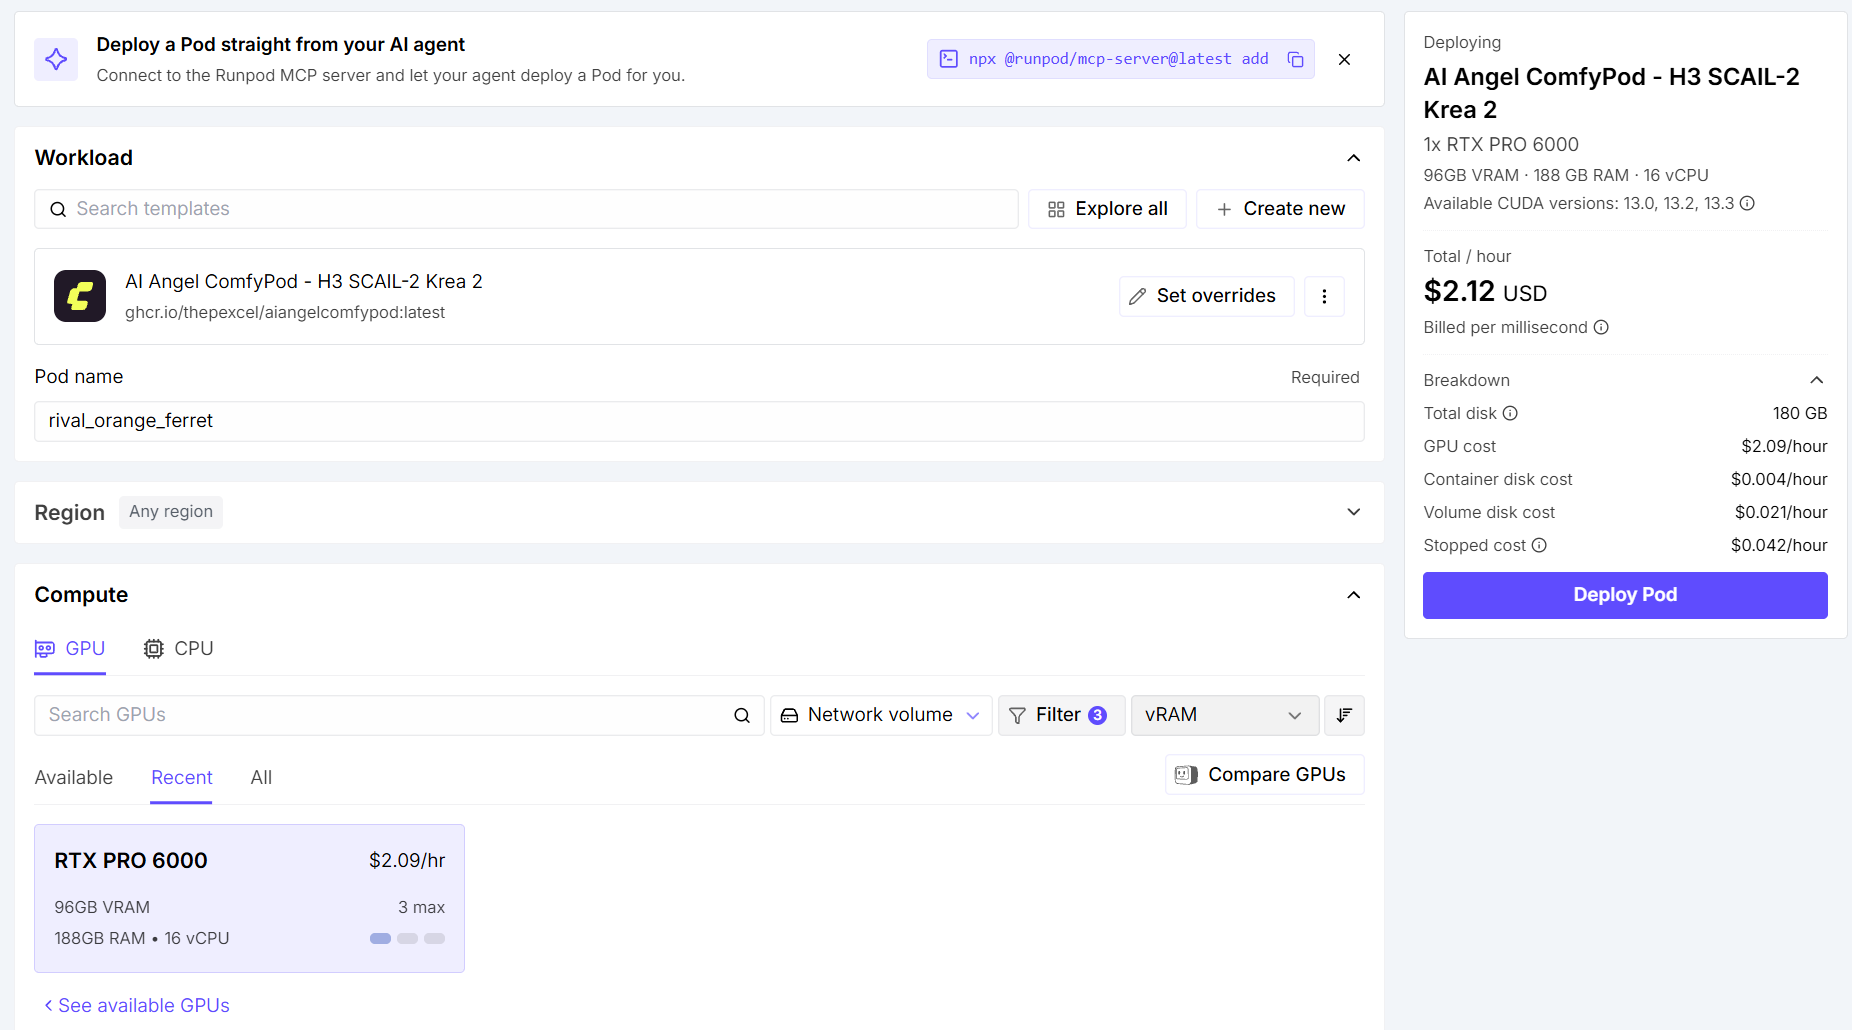
กดปุ่มเดียว RunPod เลือก Template ให้แล้ว ตั้งการ์ดกับดิสก์
≈ 4.5 นาที จนเครื่องพร้อมเปิด Dashboard
เครื่องโหลดโมเดลเอง รอไฟเขียว ComfyUI is ready
โมเดลเริ่มต้น ≈ 61 GBสร้าง
พิมพ์ไทยได้ เลือกรูปหรือคลิป แล้วกดปุ่มเดียว
รูป ≈ 5 วิ · คลิป 10 วิ ≈ 1.1 นาที
อยากดูของจริงก่อนอ่าน ผมอัดคลิปพาทำตั้งแต่ Deploy จนได้คลิปออกมาไว้ให้แล้วครับ
วันนี้อยากทำอะไร
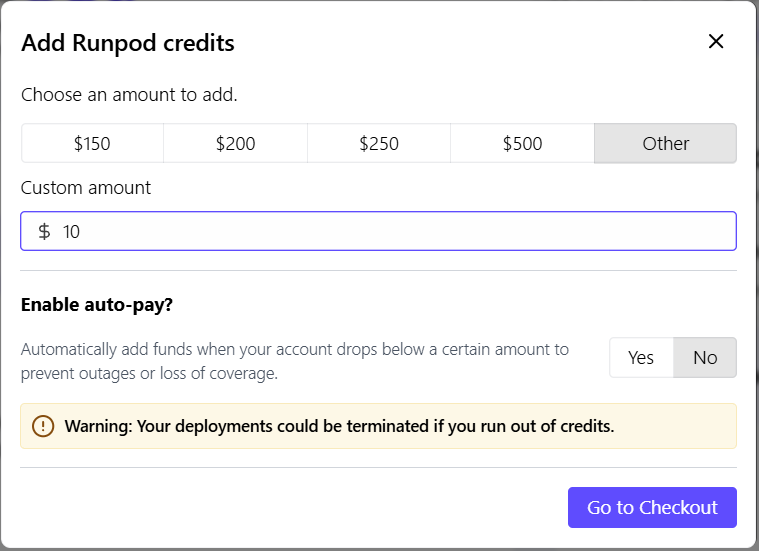
ชอบอ่านยาวรวดเดียว? เปิดแบบบทความ ทุกบทในหน้าเดียว →ค่าเช่า RTX PRO 6000 ชั่วโมงละราว 70 บาท และ RunPod คิดเงินละเอียดเป็นวินาที เปิดมาลองแป๊บเดียวแล้วปิดก็แทบไม่เสียเงิน เติมครั้งแรก $10 ก็พอลองได้หลายชั่วโมง
เปิดหน้า Deploy →กดปุ่มนี้ RunPod จะเปิดหน้า Deploy ที่เลือก Template ไว้ให้แล้ว เหลือตั้งแค่ 4 อย่าง กดดูทีละขั้น กรอบไฟจะชี้ให้ว่าต้องกดตรงไหน
จำไว้ตั้งแต่ตอนนี้ ใช้เสร็จทุกครั้ง ต้องโหลดคลิปออก → Stop → Terminate ตามลำดับ ดูบทปิดเครื่อง
พอ pod ขึ้นแล้ว ไปแท็บ Connect ของ pod กด Dashboard (พอร์ต 8189) เปิดได้ตั้งแต่เครื่องยังเตรียมตัวไม่เสร็จ แล้วดูแถบโมเดลวิ่งจนเต็ม
จำลองให้ดูเร็วขึ้น ของจริงบน RTX PRO 6000 ราว 1.5 นาที ขึ้นกับเครื่องที่สุ่มได้ ขนาดไฟล์ตามชุดเริ่มต้นจริง
อย่าเพิ่งกดสร้างคลิปก่อนแถบชุดทำคลิปเต็ม ไฟล์ที่ยังโหลดไม่ครบจะ error ทันที รอนานแล้วยังค้างที่ Downloading ดู Pod ไม่ start สักที
โมเดลที่ไม่ได้โหลดตอน boot และเลขเวอร์ชัน
ชุดที่ไม่ได้โหลดตอน boot เช่น LoRA โหมดเร็ว (h3fast) หรือ Krea 2 ยังใช้ได้ กดปุ่ม ดาวน์โหลด ที่ฟอร์มขึ้นมาให้เองตอนต้องใช้ โหลดเสร็จใช้ได้ทันทีไม่ต้อง restart
มุมขวาบนของ Dashboard มีปุ่มสลับ EN/ไทย และเลขเวอร์ชัน เช่น v1.33 เจอปัญหาแล้วทักมา บอกเลขนี้ด้วยจะช่วยได้เร็วขึ้น
RunPod คิดเงินตลอดเวลาที่ pod ยังอยู่ แม้ไม่ได้ใช้งานแล้ว ลองกดสามปุ่มนี้ตามลำดับที่ถูกต้องดู
อย่าหยุดแค่ Stop ดิสก์ของ pod ที่ Stop ค้างไว้ยังคิดเงิน $0.20/GB/เดือน (100 GB ตกราว $20/เดือน) ถ้าไม่ได้จะกลับมาใช้เครื่องเดิมเร็วๆ นี้ ให้ Terminate ทุกครั้ง
เลื่อนดูว่าเปิดเครื่องนานเท่านี้ จ่ายเท่าไหร่ และได้คลิป 10 วินาทีกี่คลิป ตัวเลขมาจากการวัดจริงบน RTX PRO 6000
การ์ดจอ
ขนาดคลิป
รูปอ้างอิงต่อคลิป
เปิดเครื่องนาน
แต่ละช่องคือ 1 คลิป
ตัวเลขพวกนี้มาจากไหน
วัดจริงบน RTX PRO 6000 แถวละ 2 ครั้งแล้วเฉลี่ย (8 steps, Sparse attention เปิดตามค่าเริ่มต้น, 23 ก.ย. 2026) หักเวลาเปิดเครื่องและคลิปแรกแล้ว · RTX 5090 คำนวณจากอัตราช้ากว่า 2.5 เท่า · ราคาเช่าตามหน้า RunPod ก.ย. 2026 ยังไม่รวมค่าดิสก์ราว $0.014/ชม.
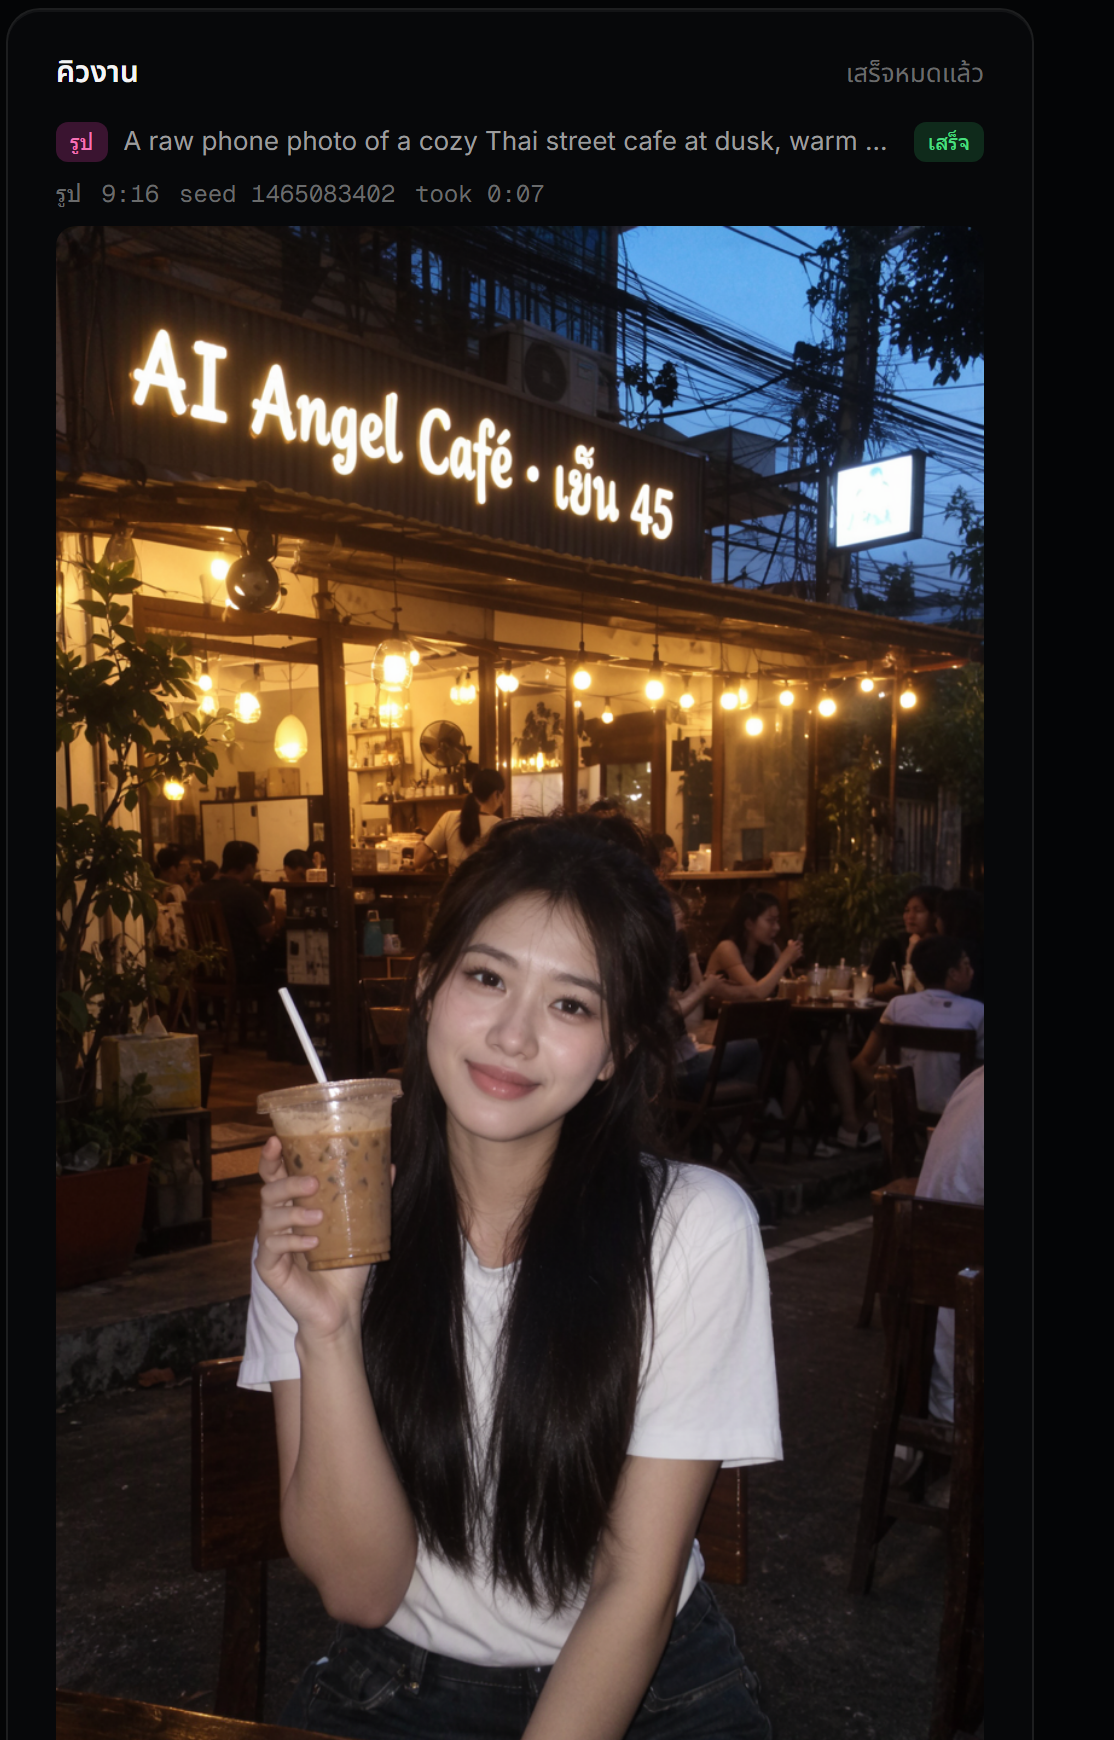
ใน Dashboard ไปแท็บ สร้าง แล้วกด รูป โมเดล Qwen Image 2.1 โหลดมาตั้งแต่ boot แล้ว ลองตั้งค่าในฟอร์มจำลองนี้ดู จะเห็นขนาดรูปจริงกับเวลาที่ต้องรอ
โหมด
สัดส่วน
ขนาด
768 × 1344 พิกเซล
จำนวน
- ใส่ได้ถึง 16 รูป เรียกว่า <image1> <image2> เช่น เอาเสื้อจากรูป 2 ไปใส่ให้คนในรูป 1
- ไม่มีแถวสัดส่วนกับขนาด รูปที่ได้เท่ารูปแรกที่ใส่
- ช่อง Seed เว้นว่างไว้ ใช้ seed ของรูปต้นฉบับ ภาพที่แก้จะพัง
LoRA ของฝั่งรูป และที่มาของตัวเลข
ช่องเลือก LoRA โชว์เฉพาะตัวที่ใช้กับโมเดลที่เลือกอยู่ ชุด qwen21 แถมมาสองตัวคือ BFS Best Face Swap กับ Canon UltraReal อยากได้เพิ่มกด โหลด LoRA รูปเพิ่มเติม ในแท็บ โมเดล (ต้องมีคีย์ Civitai) อยากใช้ LoRA ของ Krea 2 ให้สลับแถว โมเดล เป็น Krea 2 · ใส่ตัวอื่นเองดู เพิ่มโมเดลหรือ LoRA เอง
เวลาวัดจริงบน RTX PRO 6000 ตอนเครื่องอุ่นแล้ว ที่ 1 MP (20 ก.ย. 2026) · รูปแรกหลัง boot ช้ากว่าราว 3 วิเพราะต้องโหลดโมเดล · ตัวอย่างรูปทำตอน Template ยังใช้ Krea 2 วิธีกดเหมือนกัน · 4 MP คือเพดานของ Qwen Image 2.1 เอง
MOSS-Image สร้างรูปจากข้อความได้อย่างเดียว แต่ทำได้สองเรื่องที่ตัวอื่นทำไม่ได้ คือวางของตรงจุดที่วาดกล่องไว้ และเขียนตัวหนังสือในรูป ภาษาไทยก็เขียนได้ เลือกที่แถว โมเดล ของฟอร์มรูป
- ขั้น 2 กด วางด้วยกล่อง ลากบนรูปเพื่อวาด ลากมุมขวาล่างเพื่อย่อขยาย
- prompt ข้างบนเล่าภาพรวม กล่องบอกว่าตรงนั้นมีอะไร พิมพ์อังกฤษ
- วาดของข้างหลังก่อน ของด้านหน้าทีหลัง ได้ถึง 16 กล่อง
LoRA, เวลา และ template ใน ComfyUI
LoRA ใส่ได้ถึง 6 ตัว ช่องเลือกโชว์เฉพาะของ MOSS · BunnySlop (อนิเมะ) มากับชุด moss ใช้ 0.8 · Lenovo UltraReal Moss (แนวรูปถ่ายจริง) 0.8 โหลดจาก โหลด LoRA รูปเพิ่มเติม ในแท็บโมเดล · Moss Realism slider อยู่ในชุด 18+ เริ่มที่ 2.0 ซ้อนบน Lenovo
| สั่งอะไร | เวลา |
|---|---|
| 1 MP 1 ใบ (มีหรือไม่มี LoRA) | ~6 วิ |
| 1 MP ×2 | ~7 วิ |
| 2 MP 1 ใบ | ~13 วิ |
| รูปแรกหลังโหลดโมเดล | ~12 วิ |
อยากต่อ graph เอง เปิด ComfyUI (พอร์ต 8188) กด Templates ค้น MOSS-Image: Layout-Guided Text to Image แต่ node วาดกล่องในนั้นใช้ได้เฉพาะหน้าตาแบบ Nodes 2.0 วาดใน Dashboard ง่ายกว่า · อยากได้ MOSS ตั้งแต่ boot เติม moss ท้าย MODELS
วัดบน RTX PRO 6000 ตอนโมเดลโหลดอยู่แล้ว 29 ต.ค. 2026 · กรอบบนรูปวางตามตำแหน่งที่วาดในฟอร์มจริง
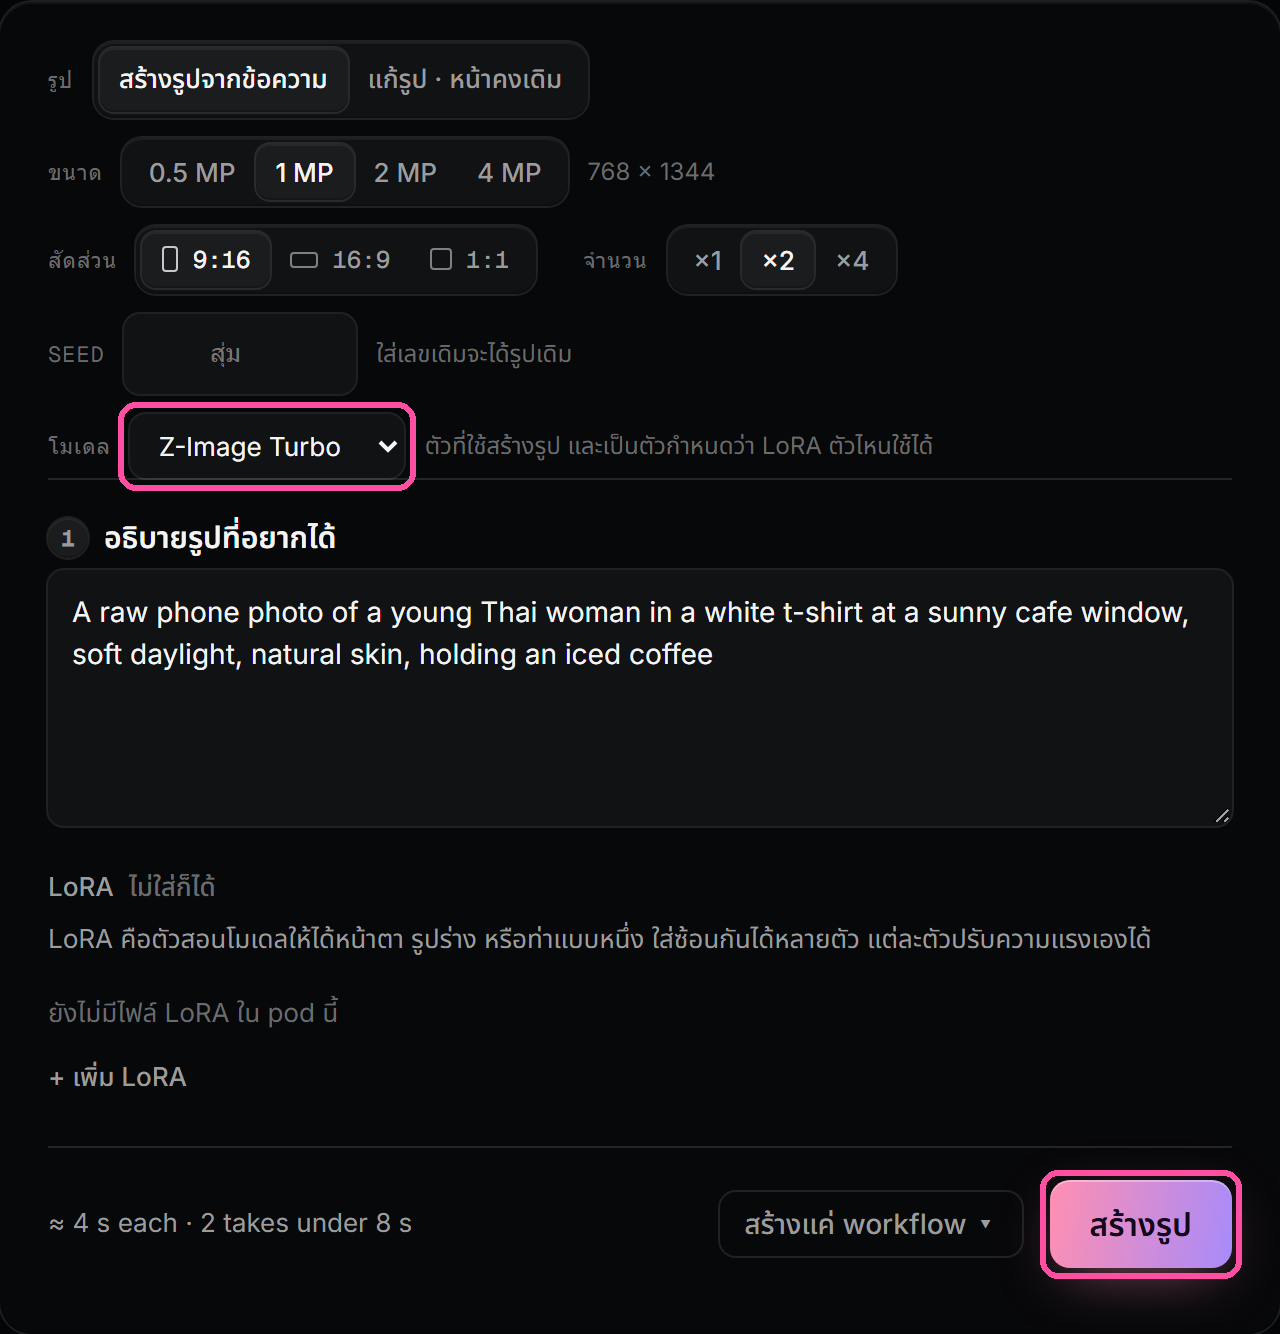
Z-Image Turbo เป็นโมเดลรูปอีกตัวในฟอร์ม สร้างรูปจากข้อความได้อย่างเดียวเหมือน MOSS กด แก้รูปนี้ ที่รูปของมัน ฟอร์มจะสลับไปใช้ Qwen Image 2.1 ให้เอง
AiAngelH3 ตัวที่ทำคลิปทำภาพนิ่งได้ด้วย มันสร้างคลิปสั้นเกินกว่าจะขยับ แล้วเก็บเฟรมแรกที่คมที่สุดไว้ ไม่ต้องโหลดอะไรเพิ่ม เพราะทุก pod มีอยู่แล้ว ใหญ่สุด 2 MP
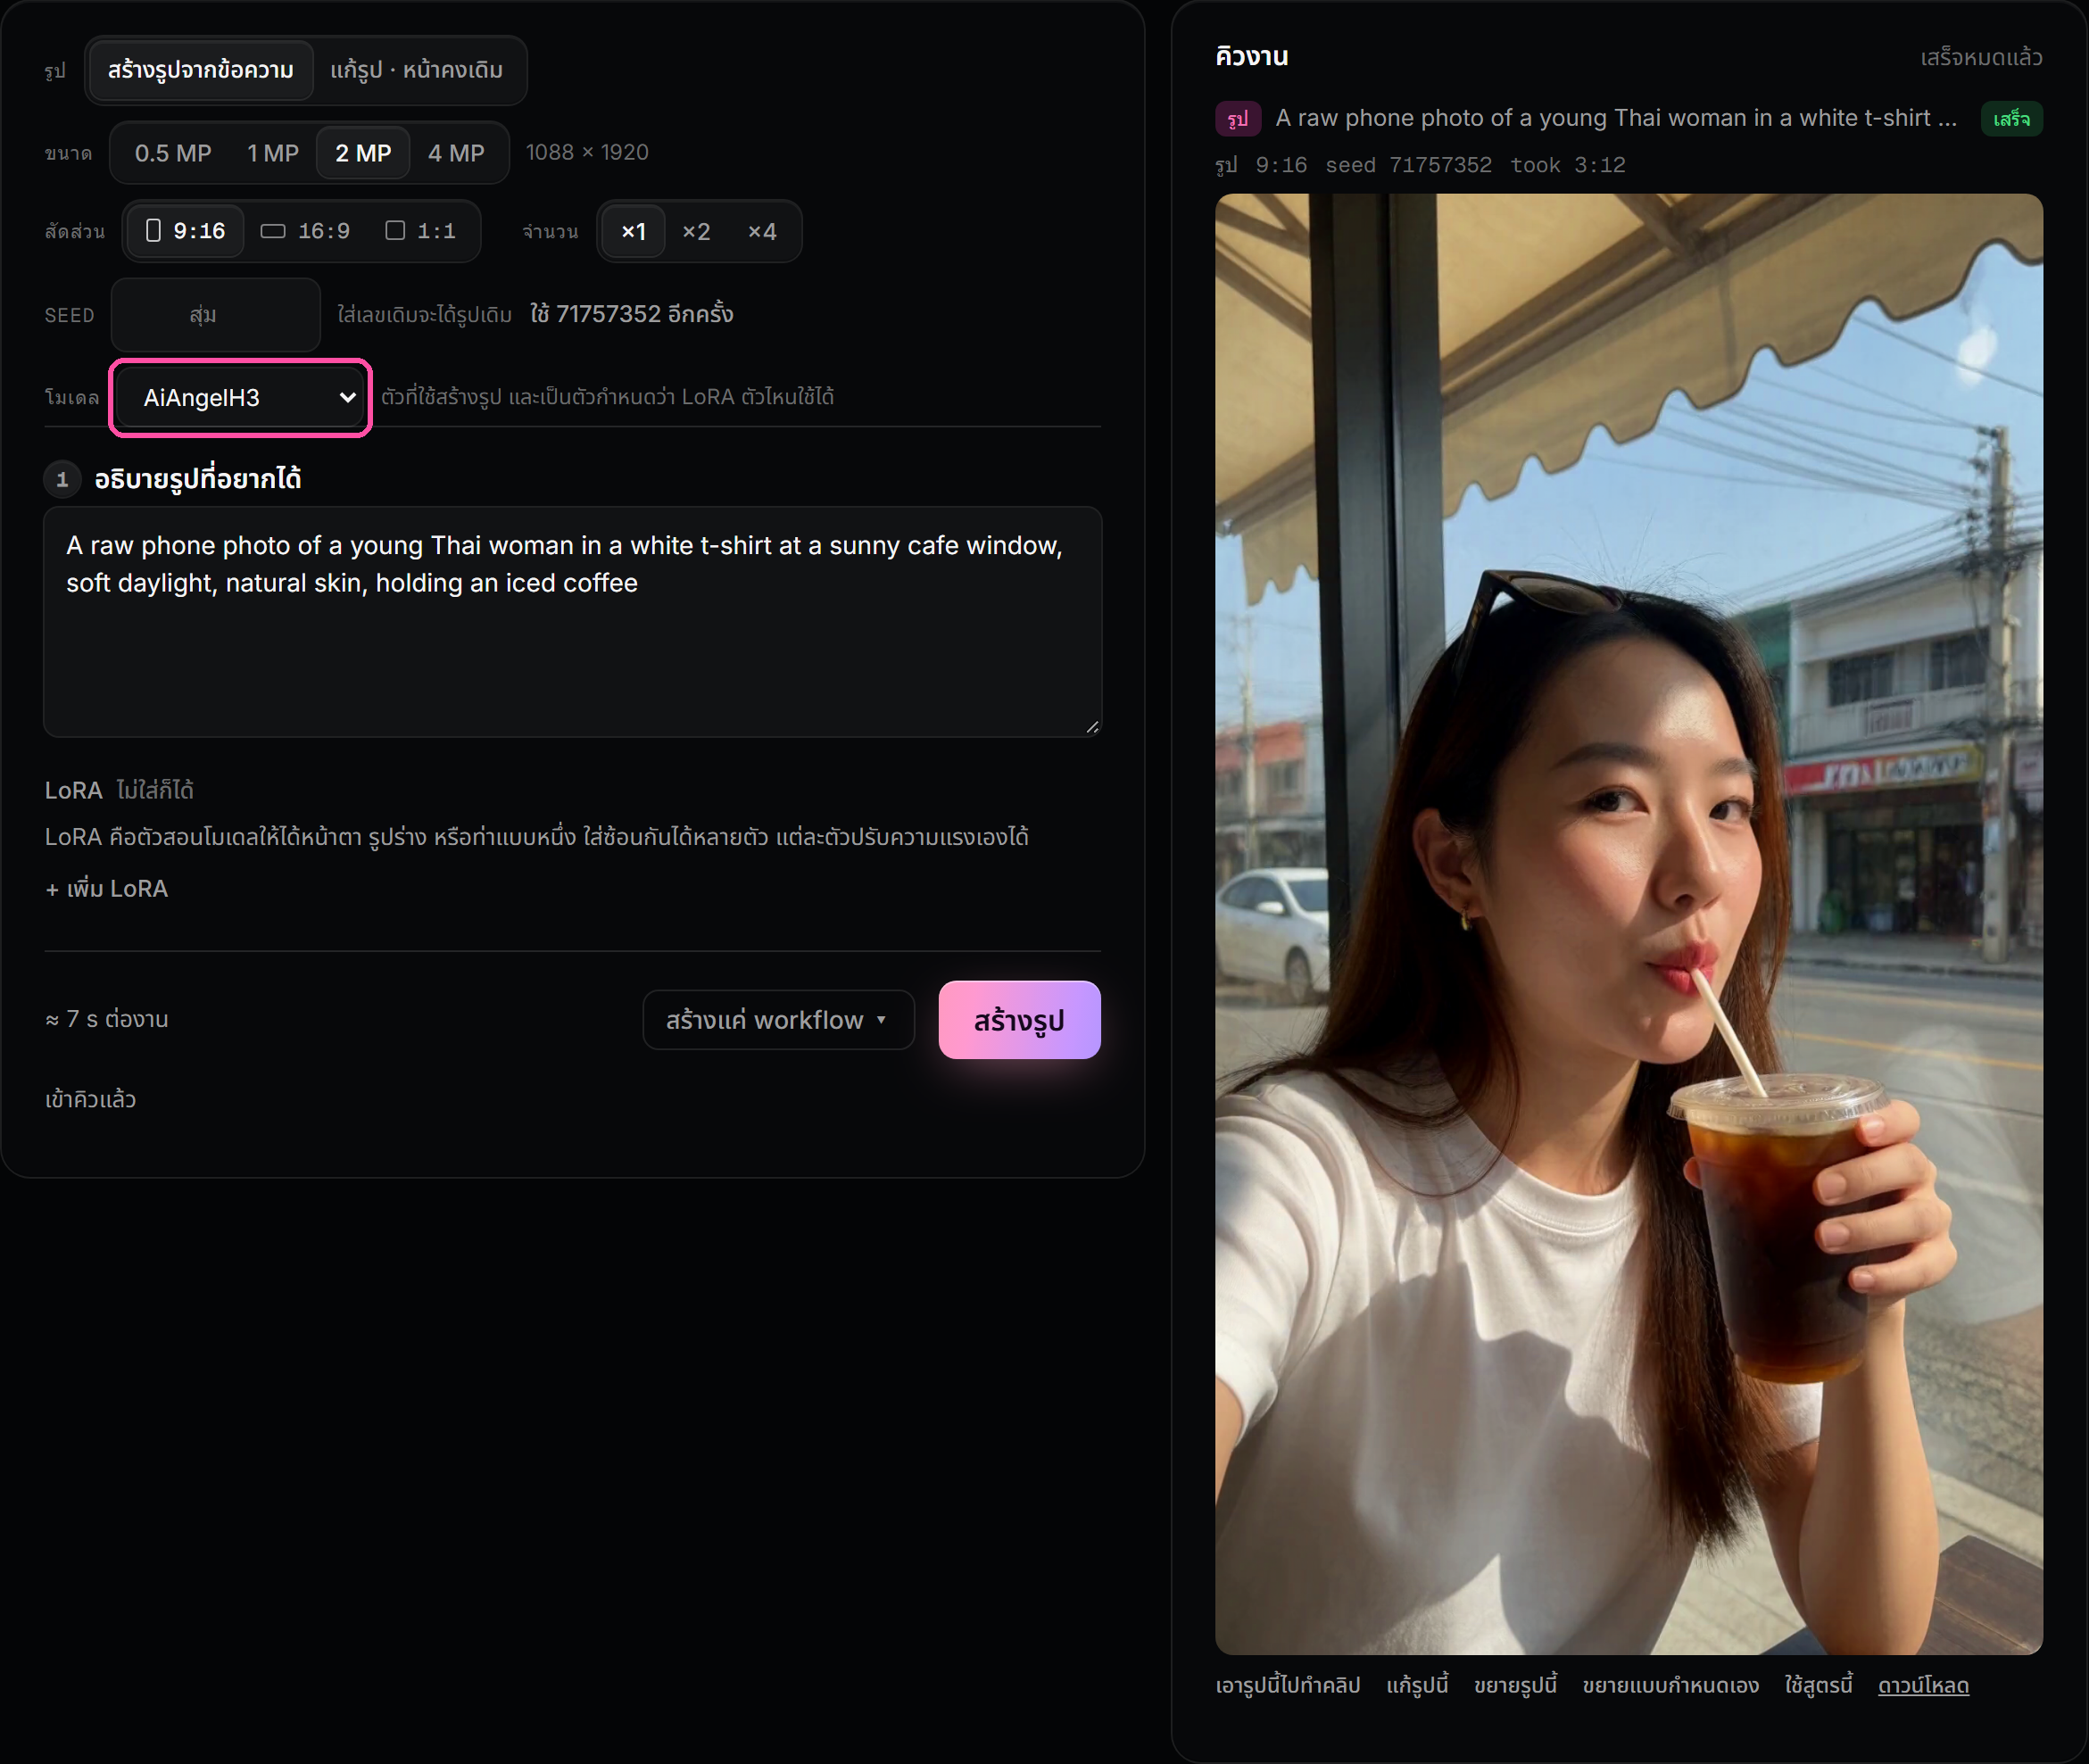
ใต้รูปที่เสร็จมีปุ่มขยายสองแบบ ทั้งคู่ไม่ได้ยืดพิกเซล แต่ให้ Qwen Image 2.1 วาดรูปเดิมใหม่ที่ขนาดใหญ่ขึ้น รายละเอียดจึงเพิ่มจริง ใช้ได้กับรูปจากทุกโมเดล
ปุ่ม
ขนาด
ความแรง
ขยาย 1024 เป็น 2048 ใช้ 34-45 วิ · ไม่มีชุด qwen21 ปุ่มจะถามแล้วโหลดให้ · วัดบน pod 20 ก.ย. 2026
แท็บ สร้าง กด คลิป กรอกฟอร์มแล้วกดปุ่มเดียว ไม่ต้องเปิด ComfyUI มาจากปุ่ม เอารูปนี้ไปทำคลิป รูปนั้นจะรออยู่ในข้อ 1 ให้แล้ว
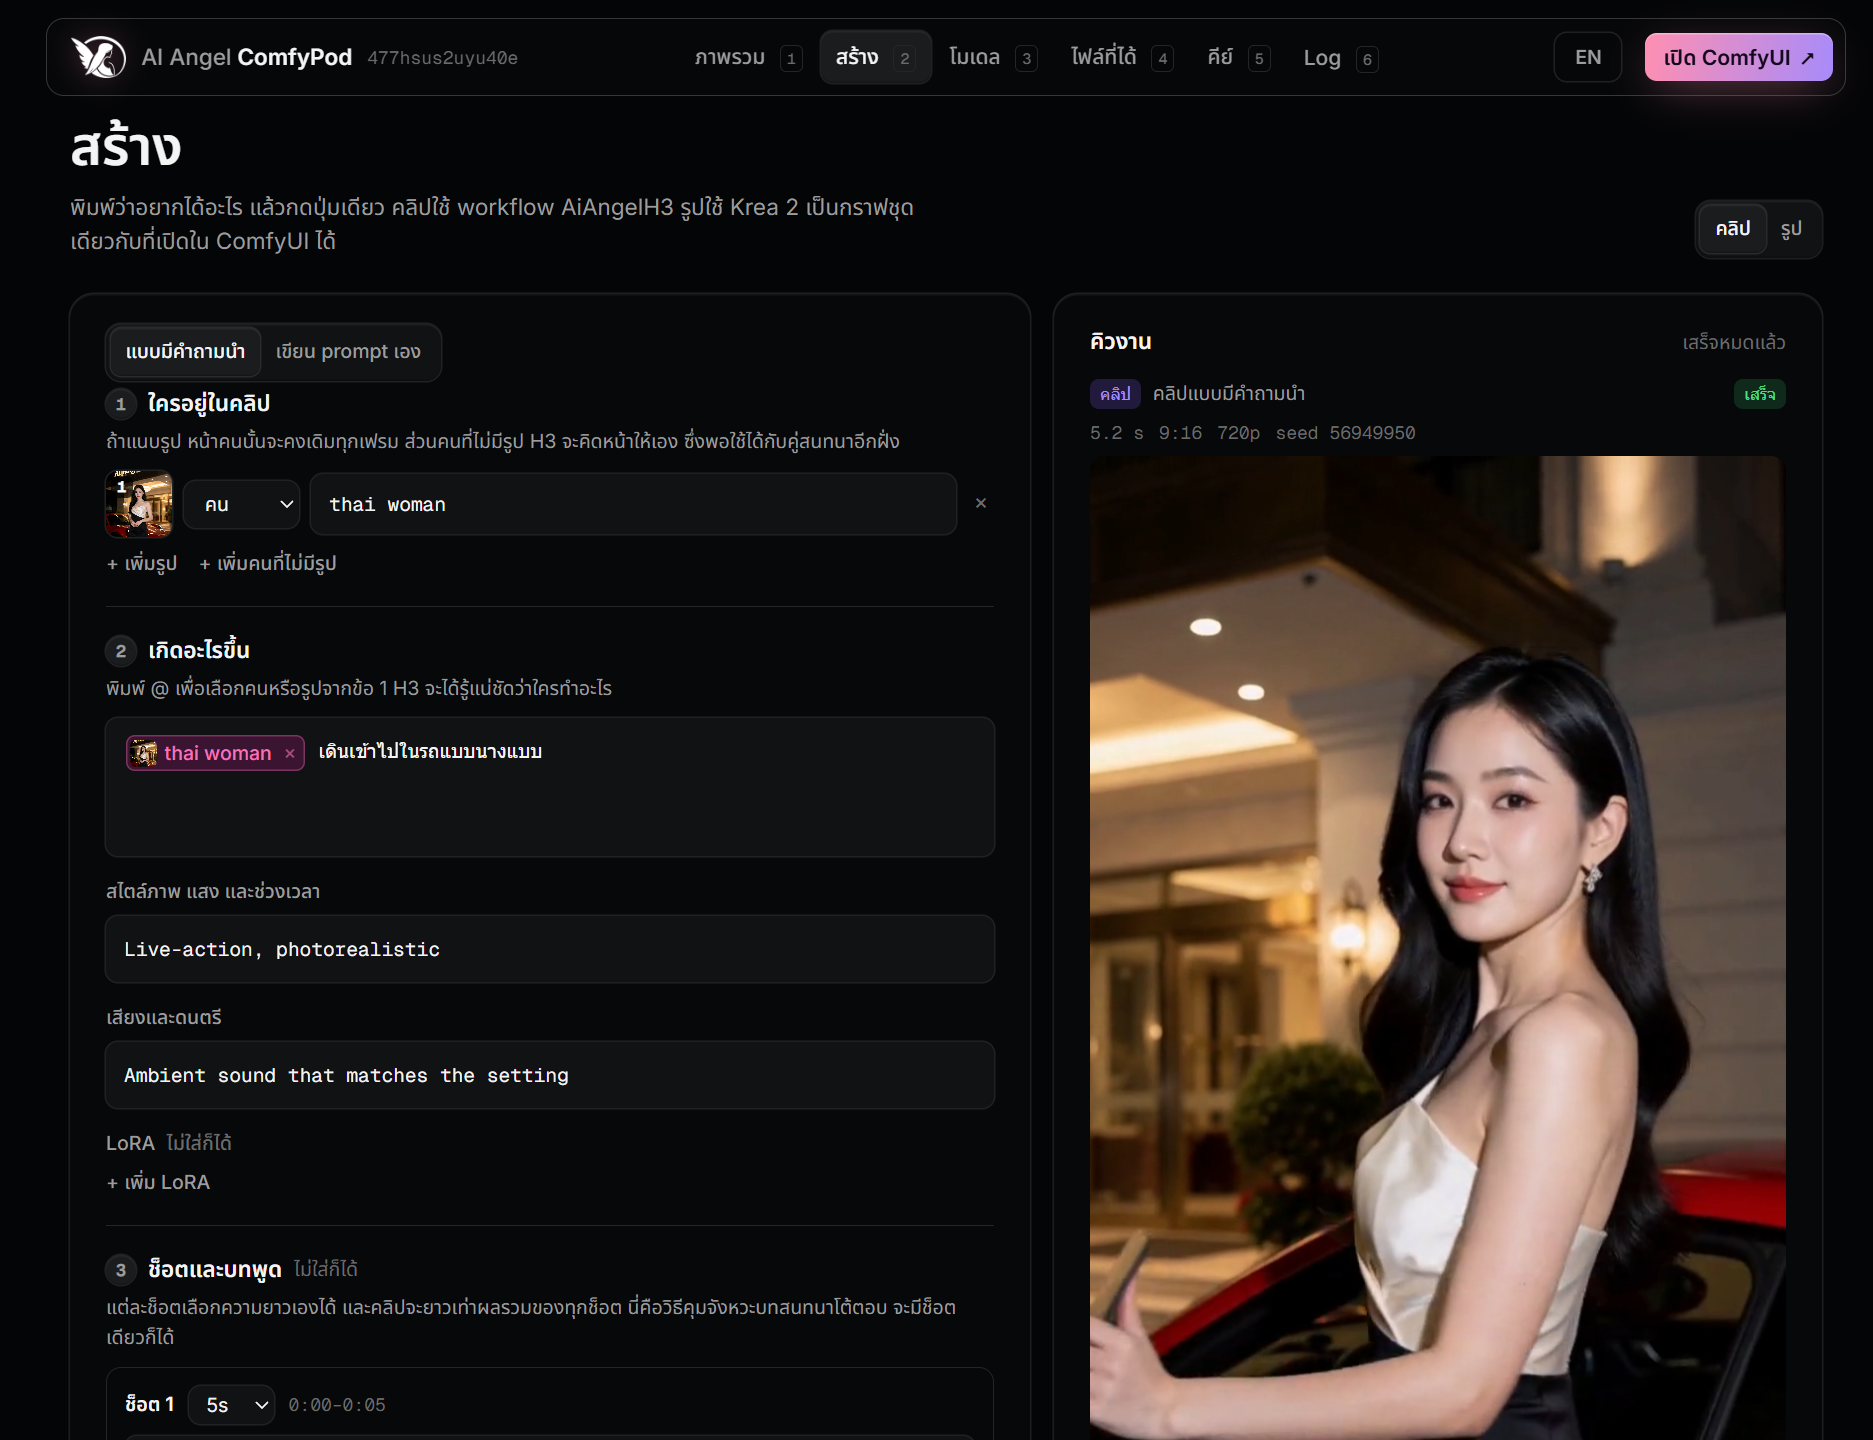
ฟอร์มคลิปมีแถว โมเดล ให้เลือก 3 ตัว สองตัวหลังเป็นโมเดลที่คนในชุมชน fine-tune ต่อจาก MiniMax H3 กดดูทีละตัว แล้วติ๊กดูว่าดิสก์ 100 GB จะพอไหม
ดิสก์ 100 GB พอไหม
ค่าเริ่มต้นใช้ราว 61 GB
ข้อควรรู้ และวิธีโหลดตั้งแต่ boot
เร็ว กับ หมุน 360° ใช้ได้กับ AiAngelH3 เท่านั้น · ใช้สูตรนี้ พาโมเดลของคลิปนั้นกลับมาด้วย · ต่อคลิปนี้ ใช้โมเดลเดิมของคลิปเสมอ · ตัวที่ยังไม่มีใน pod ปุ่มจะมี ↓ กดดาวน์โหลดได้ไม่ต้องรีสตาร์ท ราว 4 นาทีต่อตัว · อยากได้ตั้งแต่ boot เติม singularity หรือ pinkcherry ท้าย MODELS
ใส่รูปคนรูปเดียว กล้องจะหมุนรอบตัวครบวงแล้วกลับมาจบที่รูปเดิม ทุกอย่างในรูปหยุดนิ่ง มีแค่กล้องที่เคลื่อน คลิปเลยเล่นวนต่อกันได้เนียน ใช้ LoRA 360 Orbit ของ Pablo Dawson
- แท็บ สร้าง กด คลิป ตรง รูปที่ใส่ เลือก หมุน 360°
- กด + เพิ่มรูป รูปเต็มตัวหรือครึ่งตัวที่มีที่ว่างรอบๆ ได้ผลดีสุด
- ความยาว 3 วินาที คือค่าที่ LoRA เทรนมา
- จะเอาไปทำ Reel ติ๊ก 720p ไว้ คลิปคมกว่า
เวลาวัดบน RTX PRO 6000 ตอนเครื่องอุ่น 5 ต.ค. 2026 · LoRA: huggingface.co/pablodawson
ภาพจำลองการทำงาน ไม่ใช่เฟรมจากคลิปจริง
คลิปเดียวไม่ควรยาวเกิน 15 วินาที เรื่องยาวกว่านั้นใช้ คลิปยาว Dashboard ทำทีละช่วงแล้วต่อให้เอง หน้าเดิม เสียงเดิม ฉากไหลต่อกัน คลิปนี้ 42 วินาที จากรูปเดียว 4 ช่วง
ช่วงของคลิป · กดดูแต่ละช่วง
วิธีกด ข้อจำกัด และปุ่มต่อคลิปนี้
แท็บ สร้าง → คลิป โหมด แบบมีคำถามนำ กรอกข้อ 1-4 ตามปกติ ตรง ความยาว เลือก คลิปยาว แต่ละช่วงมีช่อง ช่วงนี้เกิดอะไรขึ้น กับบทพูดของตัวเอง แล้วกด สร้างคลิปยาว ปิดหน้าเว็บไปทำอย่างอื่นได้
ติ๊ก 720p ตั้งแต่ช่วงแรก คลิปที่ต่อแล้วทำเป็น 720p ทีหลังไม่ได้ · ปักเฟรม และหมุน 360° ใช้กับคลิปยาวไม่ได้ · จำนวนได้แค่ ×1 · ช่วงไหนพัง ช่วงก่อนหน้ายังอยู่ครบ กด ต่อคลิปนี้ ที่ช่วงสุดท้ายที่ดีแล้วทำต่อ
ต่อคลิปนี้ มีใต้ทุกคลิป ฟอร์มกลับมาพร้อมคน รูป สไตล์ LoRA เดิม เหลือฉากกับบทพูดให้เขียนต่อ ใช้รูปชุดเดิมไว้ เปลี่ยนรูปแล้วหน้าจะค่อยๆ เพี้ยน
เคล็ดลับ ของที่ต้องเห็นในภาพ เขียนลงช่องฉากด้วย อย่าใส่แค่ในบทพูด · ให้ทุกช่วงอยู่ในที่เดียวกัน รอยต่อจะเนียนสุด
ใส่ วิดีโอ ให้ H3 ดูเป็นตัวอย่างได้ เลียนหน้าตา ท่าทาง เสียง หรือแก้คลิปเดิม H3 ทำคลิปใหม่ ไม่ได้ก๊อปท่าตรงๆ ถ้าอยากให้ขยับตามเป๊ะ ดู Motion video
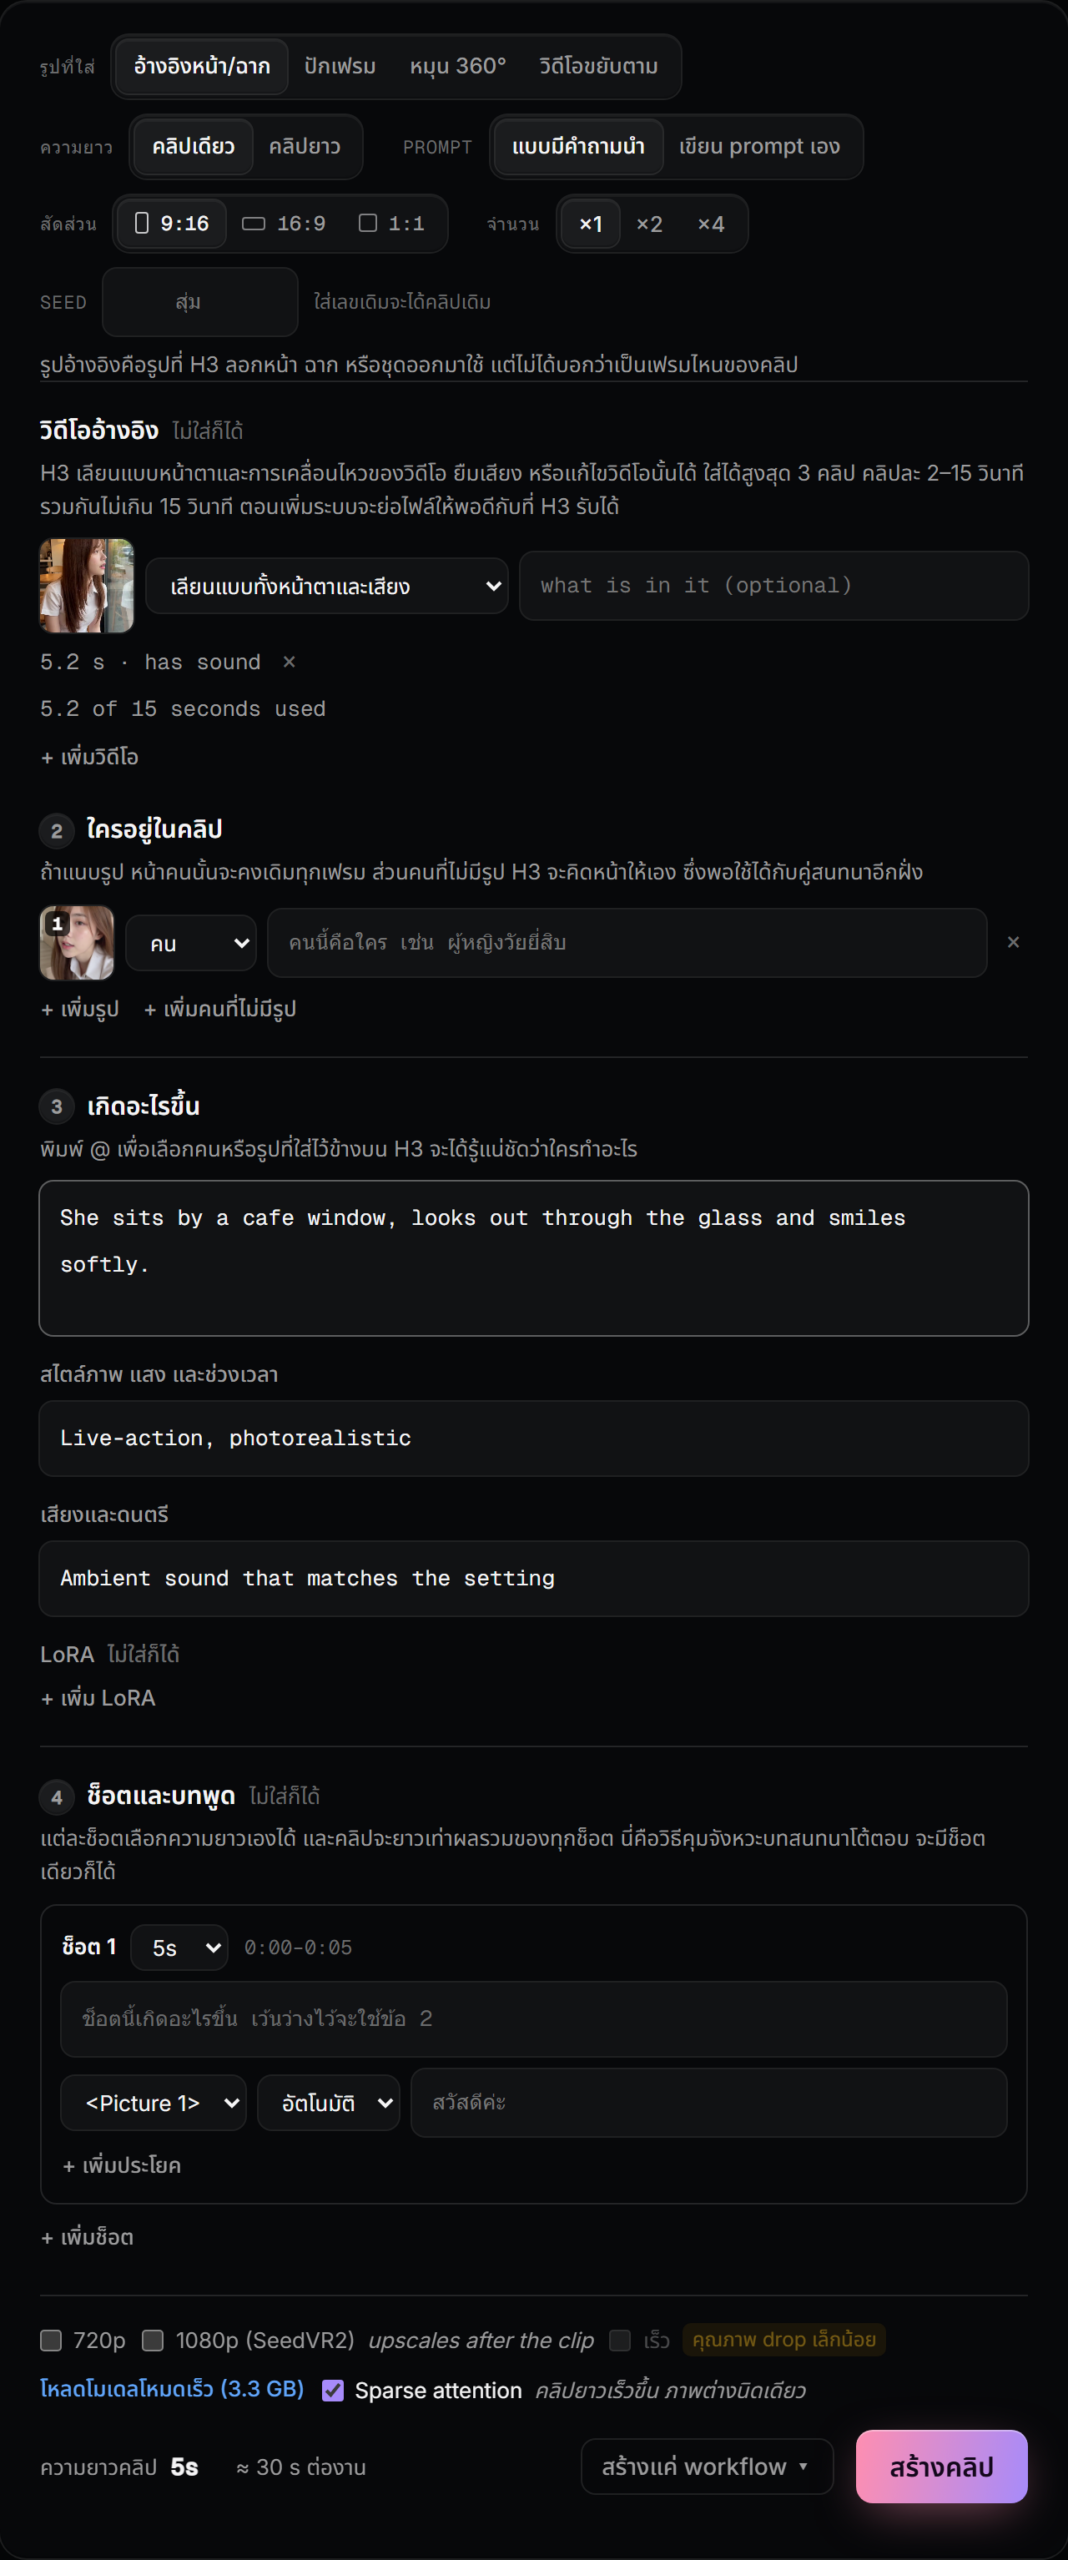
ที่เช็กแล้วคืองานรันจบและคลิปมีเสียง ยังไม่ได้วัดว่าเสียงหรือท่าทางเหมือนต้นฉบับแค่ไหน อยากเทียบให้ใส่ SEED เดิมแล้วเปลี่ยนทีละอย่าง
มีรูปคนหนึ่งรูปกับคลิปคนเต้นหรือเดิน โหมดนี้ให้คนในรูปทำท่าตามเป๊ะ ใช้ Wan SCAIL-2 คนละโมเดลกับ H3 คลิปไม่มีเสียง ยาวสุด 6.5 วิ ทั้งรูปและวิดีโอต้องมีคนคนเดียว
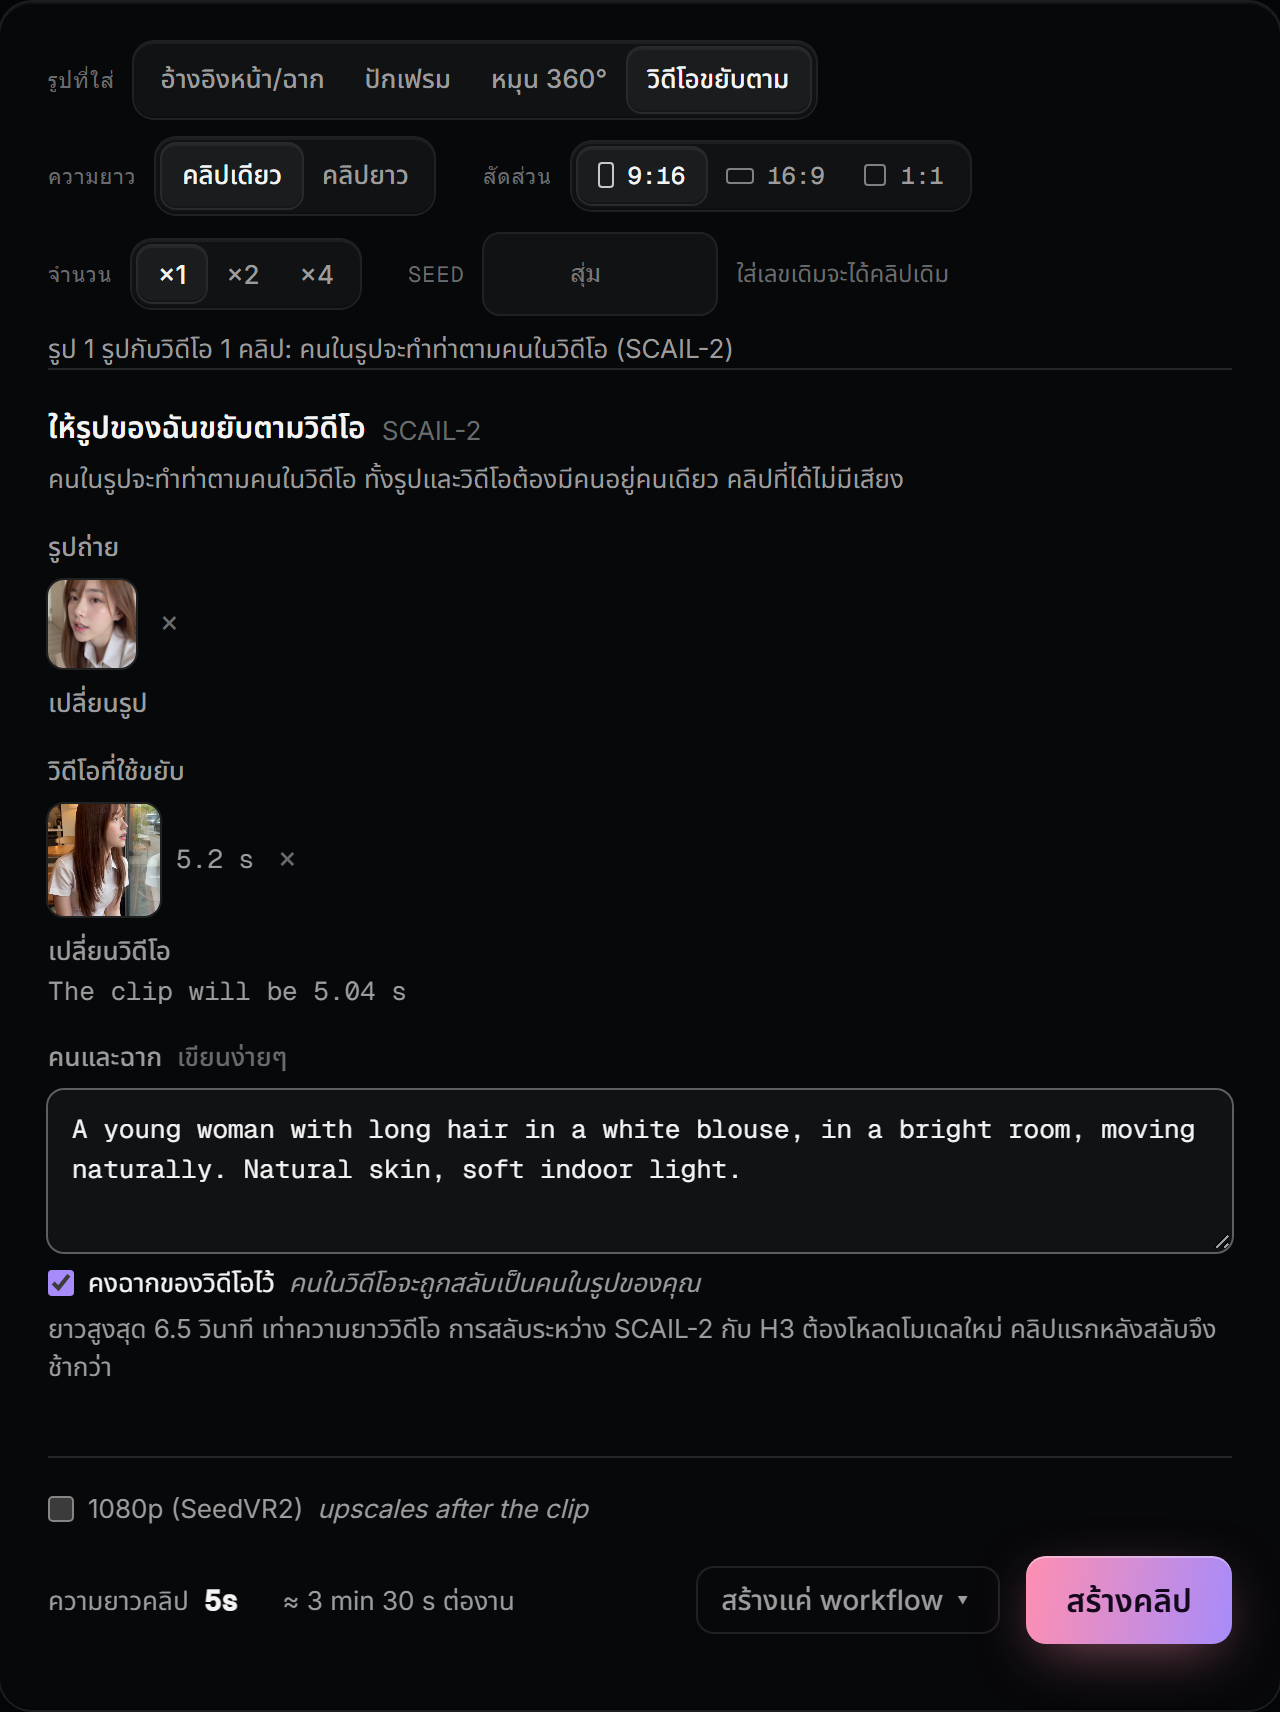
ต้องมีชุดโมเดล scail 26.7 GB ยังไม่มี ฟอร์มจะมีปุ่มให้โหลด หรือใส่ scail ใน MODELS ตอน deploy
อยากได้คลิปที่ตัดหลายช็อต มีคนคุยกัน หรือมีบทพูดภาษาไทย ใส่หลายคนในข้อ ใครอยู่ในคลิป แล้วแบ่งช็อตในส่วน ช็อตและบทพูด ลองปรับความยาวแต่ละช็อตดู
ช็อตในคลิป · กดดูทีละช็อต
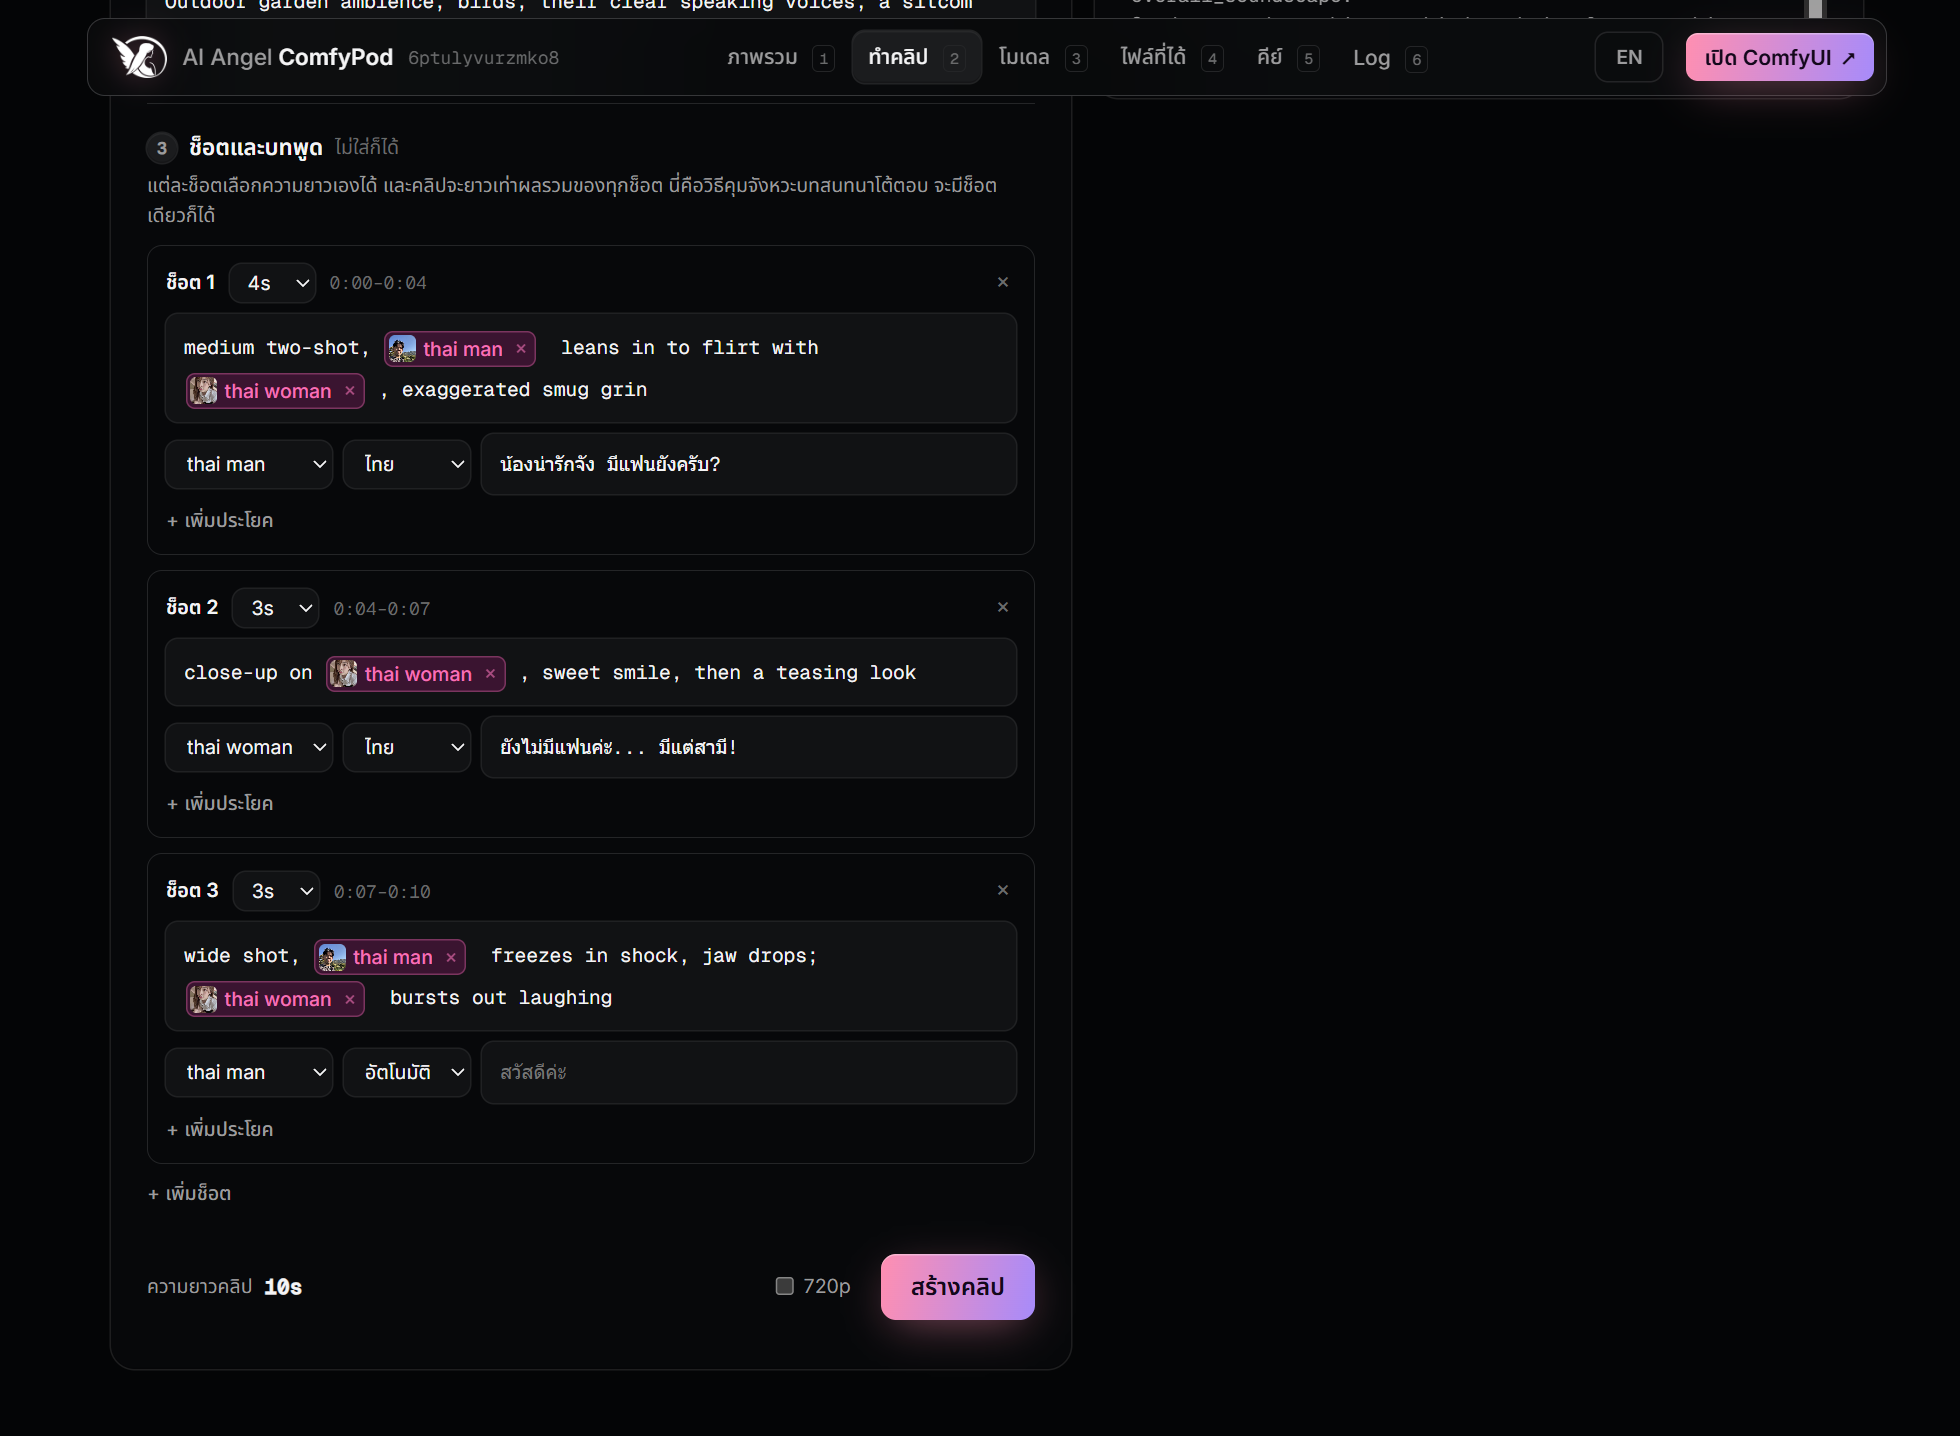
prompt ของตัวอย่าง และคำกล้องที่ใช้ได้
ช่อง เกิดอะไรขึ้น ของตัวอย่าง: “meet on a garden bench, @thai man tries to flirt @thai woman in the garden” · แต่ละช็อตใช้คำกล้องได้ เช่น medium two-shot, close-up, wide shot · บทพูดเลือกได้ว่าใครพูด ภาษาไทย อังกฤษ หรืออัตโนมัติ
สองปุ่มนี้อยู่ใต้คลิปที่เสร็จแล้ว ทั้งในการ์ด คิวงาน และในแท็บ ไฟล์ที่ได้ ปุ่มแรกเอาฟอร์มเดิมกลับมาแก้ต่อ ปุ่มที่สองทำช็อตเดิมซ้ำให้คมขึ้น
ใช้สูตรนี้ คืนอะไรกลับมาบ้าง
- ✓ คนในคลิป และรูปที่ใช้
- ✓ chip @ ที่ tag ไว้
- ✓ สไตล์ภาพ เสียง
- ✓ ช็อตและบทพูด
- ✓ โมเดลคลิปที่ใช้
- ✗ seed ไม่เติมให้เอง กดลิงก์ ใช้ … อีกครั้ง ข้างช่อง Seed ถ้าอยากได้คลิปเดิม
คลิปที่ทำจาก ComfyUI เอง หรือมาจาก pod อื่น prompt จะกลับมาเป็นก้อนเดียวในโหมด เขียน prompt เอง
ทำเป็น 720p
ทำช็อตชุดเดิมซ้ำที่ 704×1280 ด้วย prompt และ seed เดิม ได้ช็อตแบบเดิมกลับมา ปุ่มขึ้นเฉพาะคลิปที่ยังไม่เป็น 720p
คลิป 10 วิ สองคน บน RTX PRO 6000 · เร็วกว่าเพราะ ComfyUI ยังจำผลรอบแรกไว้ · ต้องมี h3upscaler ใน MODELS (ค่าเริ่มต้นมีแล้ว) · คลิปที่ปักเฟรม คลิปยาว และคลิปที่ต่อมา ใช้ปุ่มนี้ไม่ได้ ติ๊ก 720p ตั้งแต่ตอนสร้างแทน
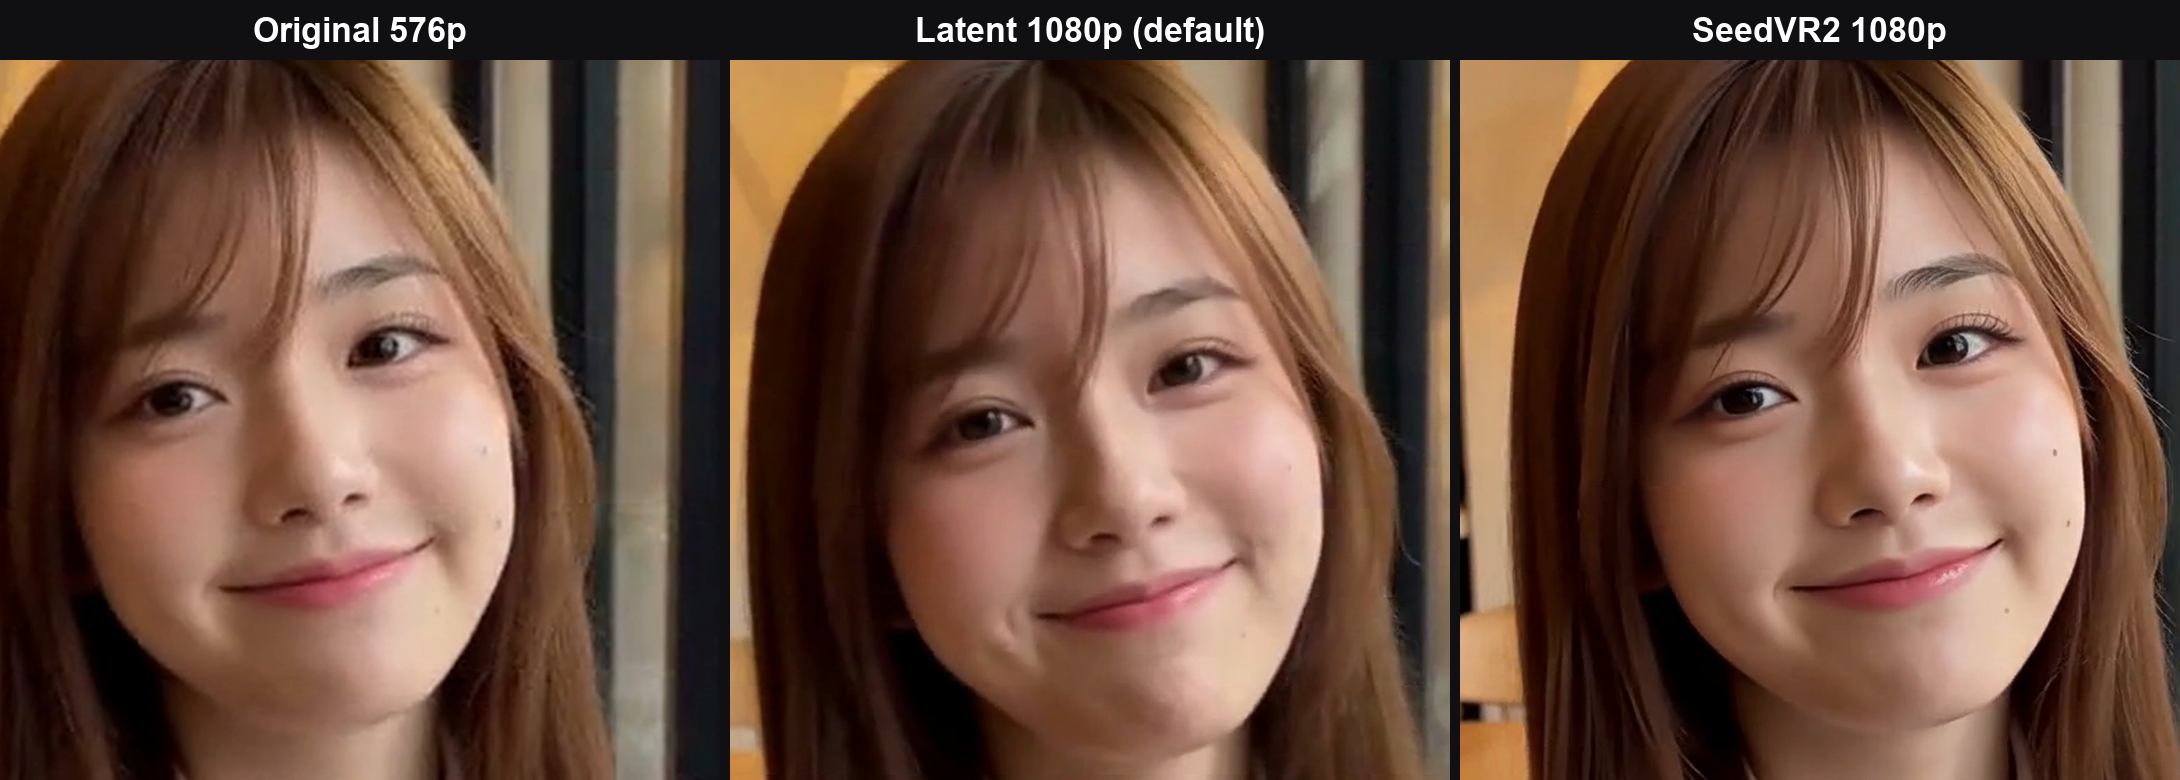
มีสองแบบ แบบหลักให้ H3 วาดคลิปเดิมใหม่ทั้งคลิปที่ 1080p หน้ายังเป็นคนเดิม ผิวดูถ่ายจริง แบบเดิมคือ SeedVR2 ขยายจากพิกเซล คมกว่าแต่ชอบเติมของที่ไม่มี เช่น อายไลเนอร์ ไฝ
คลิปของคุณเป็นแบบไหน
แบบหลักต้องมี h3upscaler ใน MODELS ตั้งแต่เปิด pod · SeedVR2 ใช้ชุด seedvr2 ราว 9 GB หน้าเว็บถามแล้วโหลดให้ ไม่ต้องรีสตาร์ท · ติ๊ก 1080p (SeedVR2) ในฟอร์มคลิป ก็สั่งอัปสเกลต่อท้ายได้เลย · วัดบน RTX PRO 6000 ตอนโมเดลอยู่ในเครื่องแล้ว
ไปแท็บ ไฟล์ที่ได้ กด ดาวน์โหลด ZIP เอาทั้งหมด หรือ ใหม่ตั้งแต่ ZIP ล่าสุด เอาเฉพาะที่ยังไม่เคยโหลด ไฟล์เยอะ ZIP แบ่งเป็นหลายไฟล์ให้ได้
ลองลบไฟล์ดู (จำลอง)
ลบแล้วหายจาก pod ถาวร เอาคืนไม่ได้ อยากเก็บให้โหลด ZIP ก่อน ปุ่มนี้มีไว้เก็บกวาดระหว่างทาง ดิสก์จะได้ไม่เต็ม
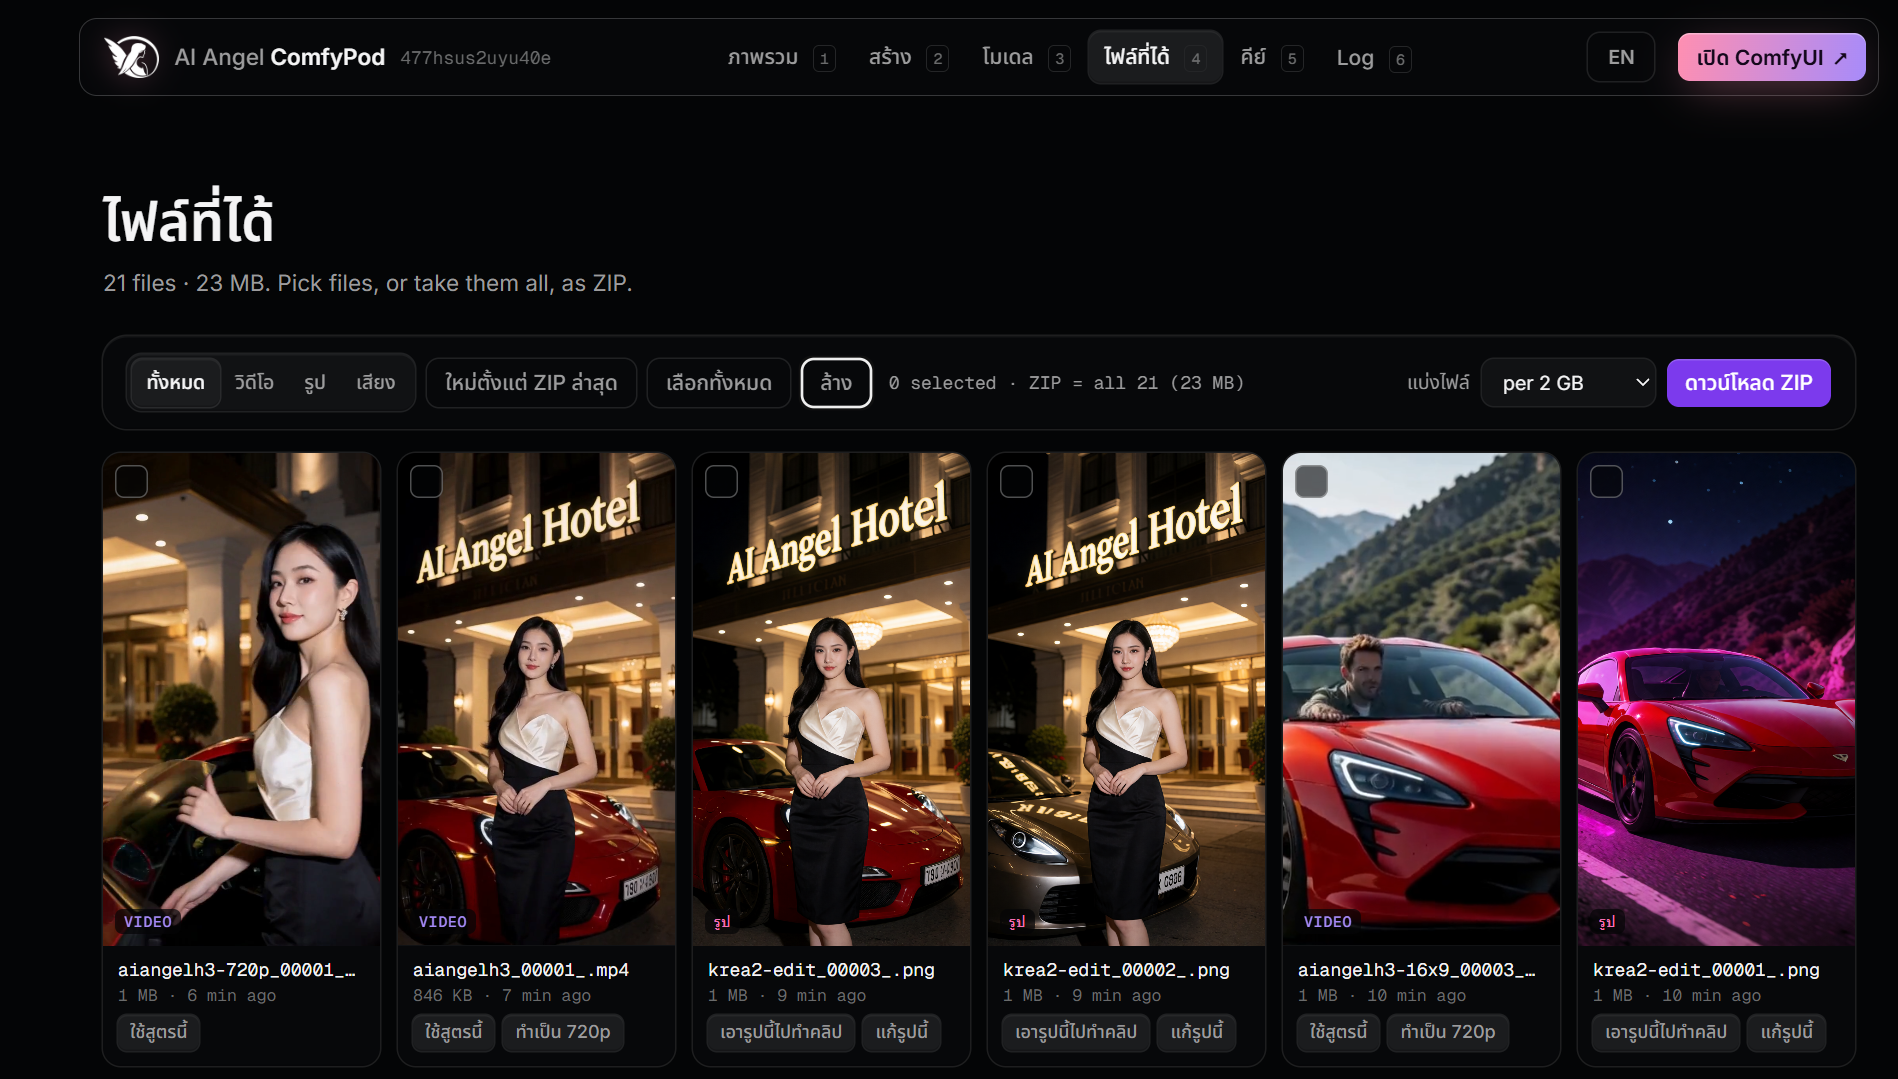
นอกจากแท็บไฟล์ที่ได้ใน Dashboard ยังมีอีกสองทาง ทางแรกเหมาะกับหยิบทีละชุด ทางที่สองเหมาะกับงานชุดใหญ่ เช่น ทิ้งให้ทำคลิปทั้งคืน
1 · Outputs ใน ComfyUI (พอร์ต 8188)
- กดไอคอน Outputs แถบซ้าย
- Download N new = zip ของที่ทำเสร็จตั้งแต่โหลดครั้งล่าสุด
- หรือคลิกเลือกรูปเล็ก แล้วกด Selected หรือ All
2 · Sync ทั้งหมดลงเครื่อง (pull.py)
ในแผง Outputs กด Sync everything to your computer โหลด pull.py แล้วรันบนเครื่องคุณ (Python 3.9 ขึ้นไป ไม่ต้องติดตั้งอะไร)
ข้ามไฟล์ที่มีแล้ว โหลดต่อจากที่ค้างได้ รันซ้ำเมื่อไหร่ก็ได้เฉพาะของใหม่ · --only video หรือ --since-hours 6 ช่วยกรอง
ทุกปุ่มใน Dashboard คือการเรียก HTTP ธรรมดา Claude Code หรือ Codex จึงสั่งทำรูป ทำคลิป ดูคิว แล้วโหลดผลกลับมาให้ได้ ขอแค่ลิงก์ Dashboard ของ pod ใส่ id ของ pod กับงานที่อยากได้ แล้ว copy ไปวาง
POD id (ส่วนหน้า -8189 ในลิงก์ Connect)
อยากได้อะไร (ไทยได้)
Dashboard ไม่มีรหัสผ่าน ใครได้ลิงก์ก็สั่ง pod คุณได้ อย่าโพสต์ลิงก์ในที่สาธารณะหรือแชตกลุ่ม
- pod ให้ agent อ่านคู่มือเฉพาะของมันที่
/agent-guide.mdตรงกับเวอร์ชันของ pod เสมอ (v1.18 ขึ้นไป) - คู่มือสั่งให้ agent ถามคุณก่อนสั่งงานชุดใหญ่ โหลดโมเดล ลบไฟล์ หรือรีสตาร์ต
- ท่าทางในคลิปควรเป็นอังกฤษ บทพูดไทยได้ agent รู้อยู่แล้ว
- Codex ต้องเปิดเน็ต:
codex -c 'sandbox_workspace_write.network_access=true' - ค่าเช่ายังเดินระหว่าง agent ทำงาน เสร็จแล้ว Stop และ Terminate
ทุกอย่างที่ Dashboard ทำคือ workflow ของ ComfyUI ธรรมดา กรอกฟอร์มให้เรียบร้อย แล้วกด สร้างแค่ workflow ▾ ข้างปุ่มสร้าง ปุ่มนี้ไม่รันอะไร
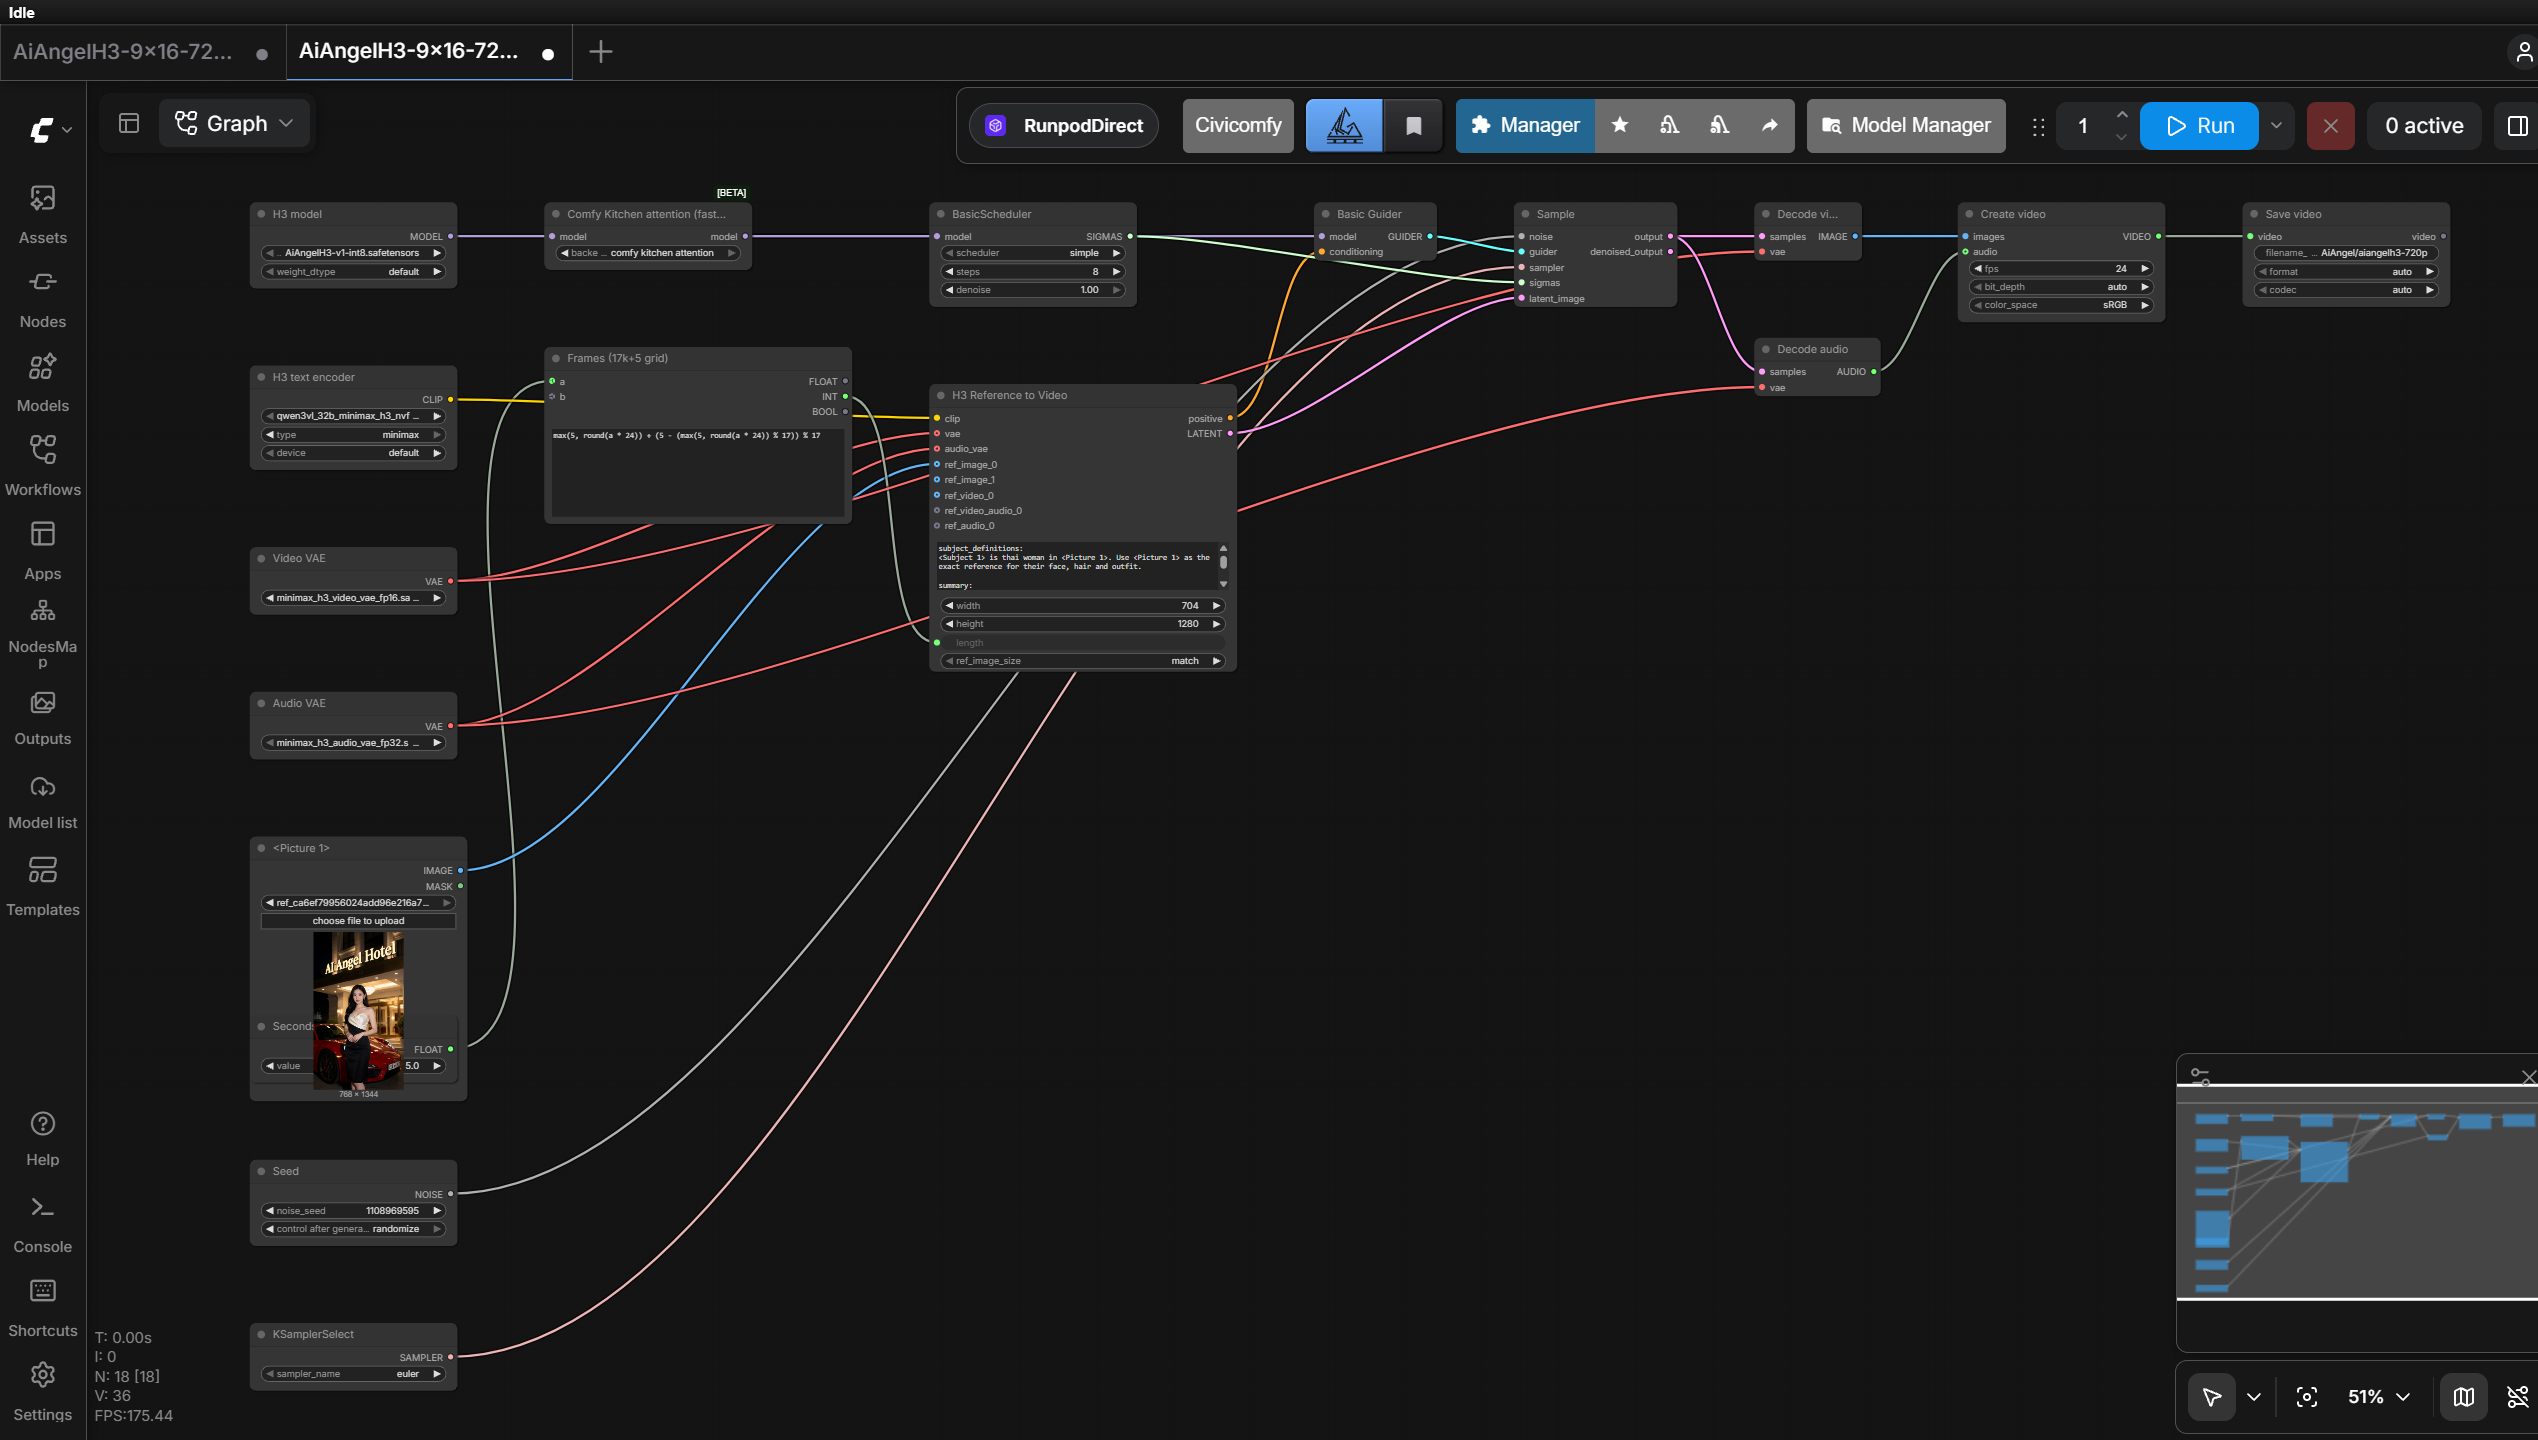
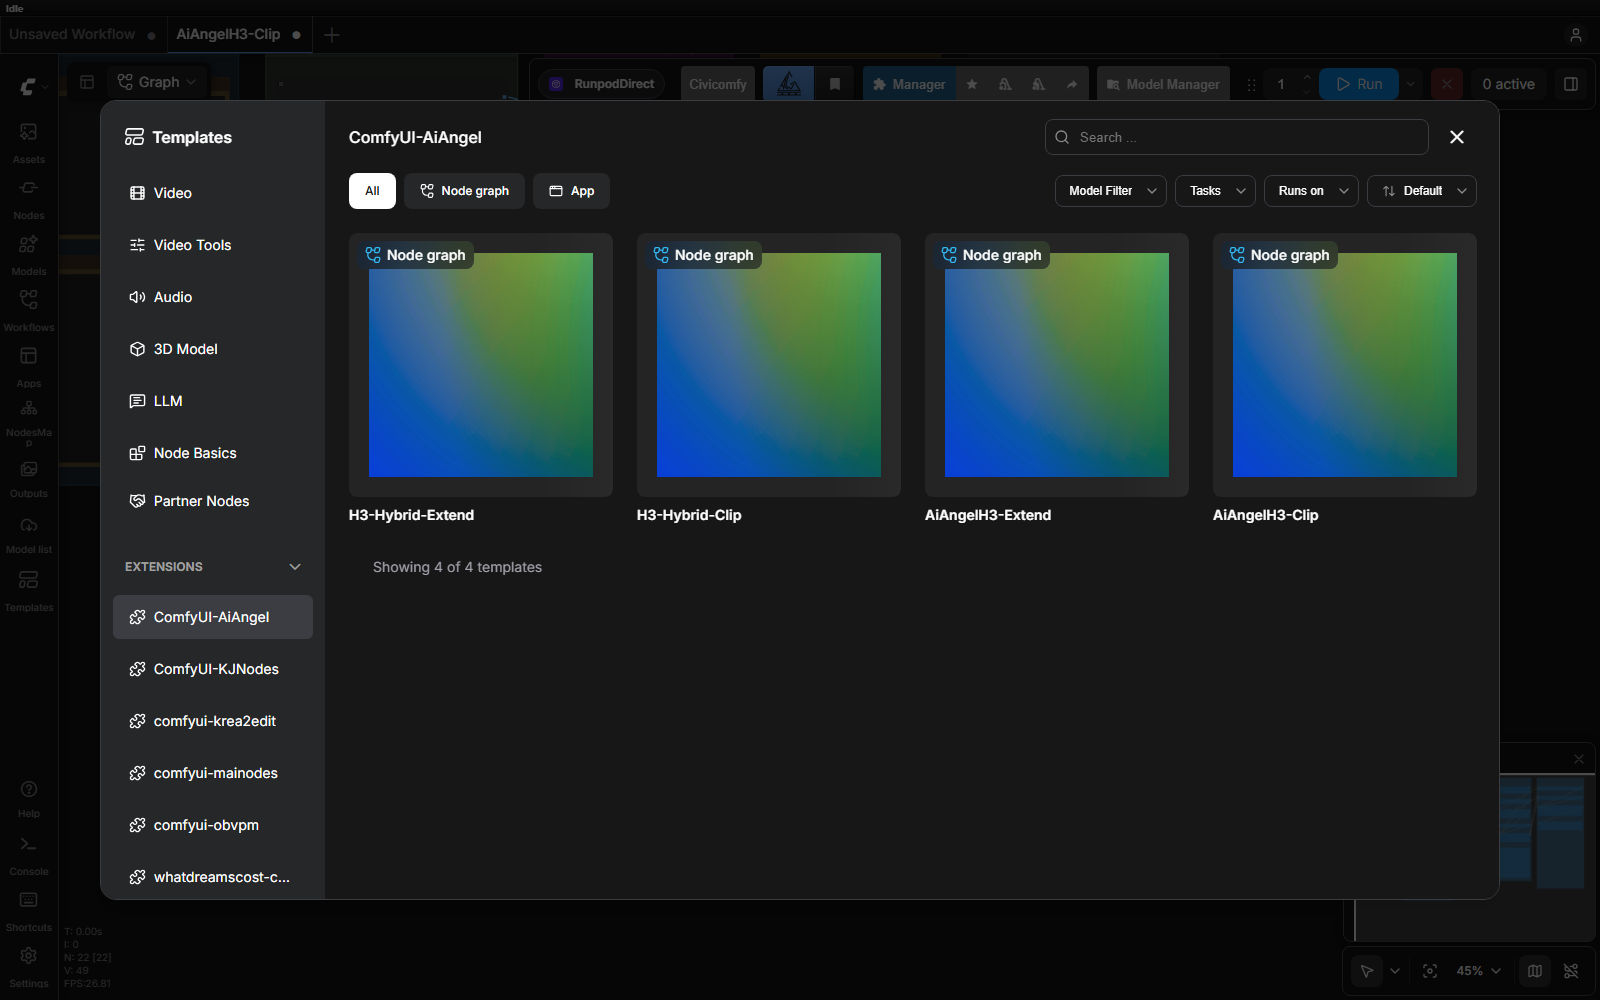
เปิด ComfyUI ครั้งแรก AiAngelH3-Clip จะเปิดขึ้นมาให้เอง อีก 3 อันอยู่ใน Templates แถบซ้าย ค้นคำว่า AiAngel หรือ H3
- เปิด ComfyUI ก่อนโมเดลโหลดเสร็จ แถบเต็มแล้วกด R refresh
- จัดงานโมเดลเดียวกันไว้ด้วยกัน สลับ H3 กับ SCAIL-2 ต้องโหลดใหม่
- GPU 1 ตัวทำทีละคลิป งานเยอะเปิดหลาย pod · อย่าใช้
--highvram
แท็บ โมเดล มีการ์ด เพิ่มโมเดลหรือ LoRA เอง วางลิงก์บรรทัดละ 1 ลิงก์ แล้วกดดาวน์โหลด ไม่ต้องรีสตาร์ท ลองวางลิงก์ที่จะใช้ในช่องนี้ หนูจะบอกว่าต้องตั้งอะไร
วางลิงก์
ดู Base Model ก่อนทุกครั้ง LoRA ใช้ได้เฉพาะโมเดลที่มันเทรนมา ฝั่งคลิปรับ LoRA ของ MiniMax H3 ฝั่งรูปรับของโมเดลรูปที่เลือก ของ Wan, SDXL, Flux, Pony ใช้ที่นี่ไม่ได้
- Civitai ต้องมี API key: Civitai → Account settings → API Keys แล้ววางในแท็บ คีย์ ครั้งเดียว
- Hugging Face ใช้ token เฉพาะ repo ส่วนตัวหรือต้องขอสิทธิ์
- หลายลิงก์คนละโฟลเดอร์ ใส่
loras|ลิงก์นำหน้าแต่ละบรรทัด - โหลดเสร็จ LoRA โผล่ในฟอร์มเองไม่กี่วินาที · ดิสก์ไม่พอ ลบชุดที่ไม่ใช้ในแท็บโมเดล
ปกติไม่ต้องแตะ ค่าเริ่มต้นโหลดชุดทำคลิปกับรูปให้ราว 60 GB ครบแล้ว ชุดอื่นกดโหลดจาก Dashboard ทีหลังได้ ถ้าอยากได้มาตั้งแต่ boot ติ๊กชุดที่ต้องการ แล้ว copy ค่า MODELS ไปวางตอน Deploy (Set overrides → Environment variables)
Volume disk ที่ตั้งไว้
ลำดับในค่า MODELS = ลำดับดาวน์โหลด ชุดที่อยากใช้ก่อนอยู่หน้า · การ์ดจออย่างต่ำ RTX 5090 อยากเร็วใช้ RTX PRO 6000 · ลิงก์อื่นที่อยากได้ตอน boot ใส่ใน EXTRA_MODELS ลิงก์ Civitai ต้องมี CIVITAI_TOKEN (เก็บเป็น RunPod secret) · ขนาดเป็นค่าประมาณ
ตอนนี้ค้างอยู่ตรงไหน กดเลือกอาการ
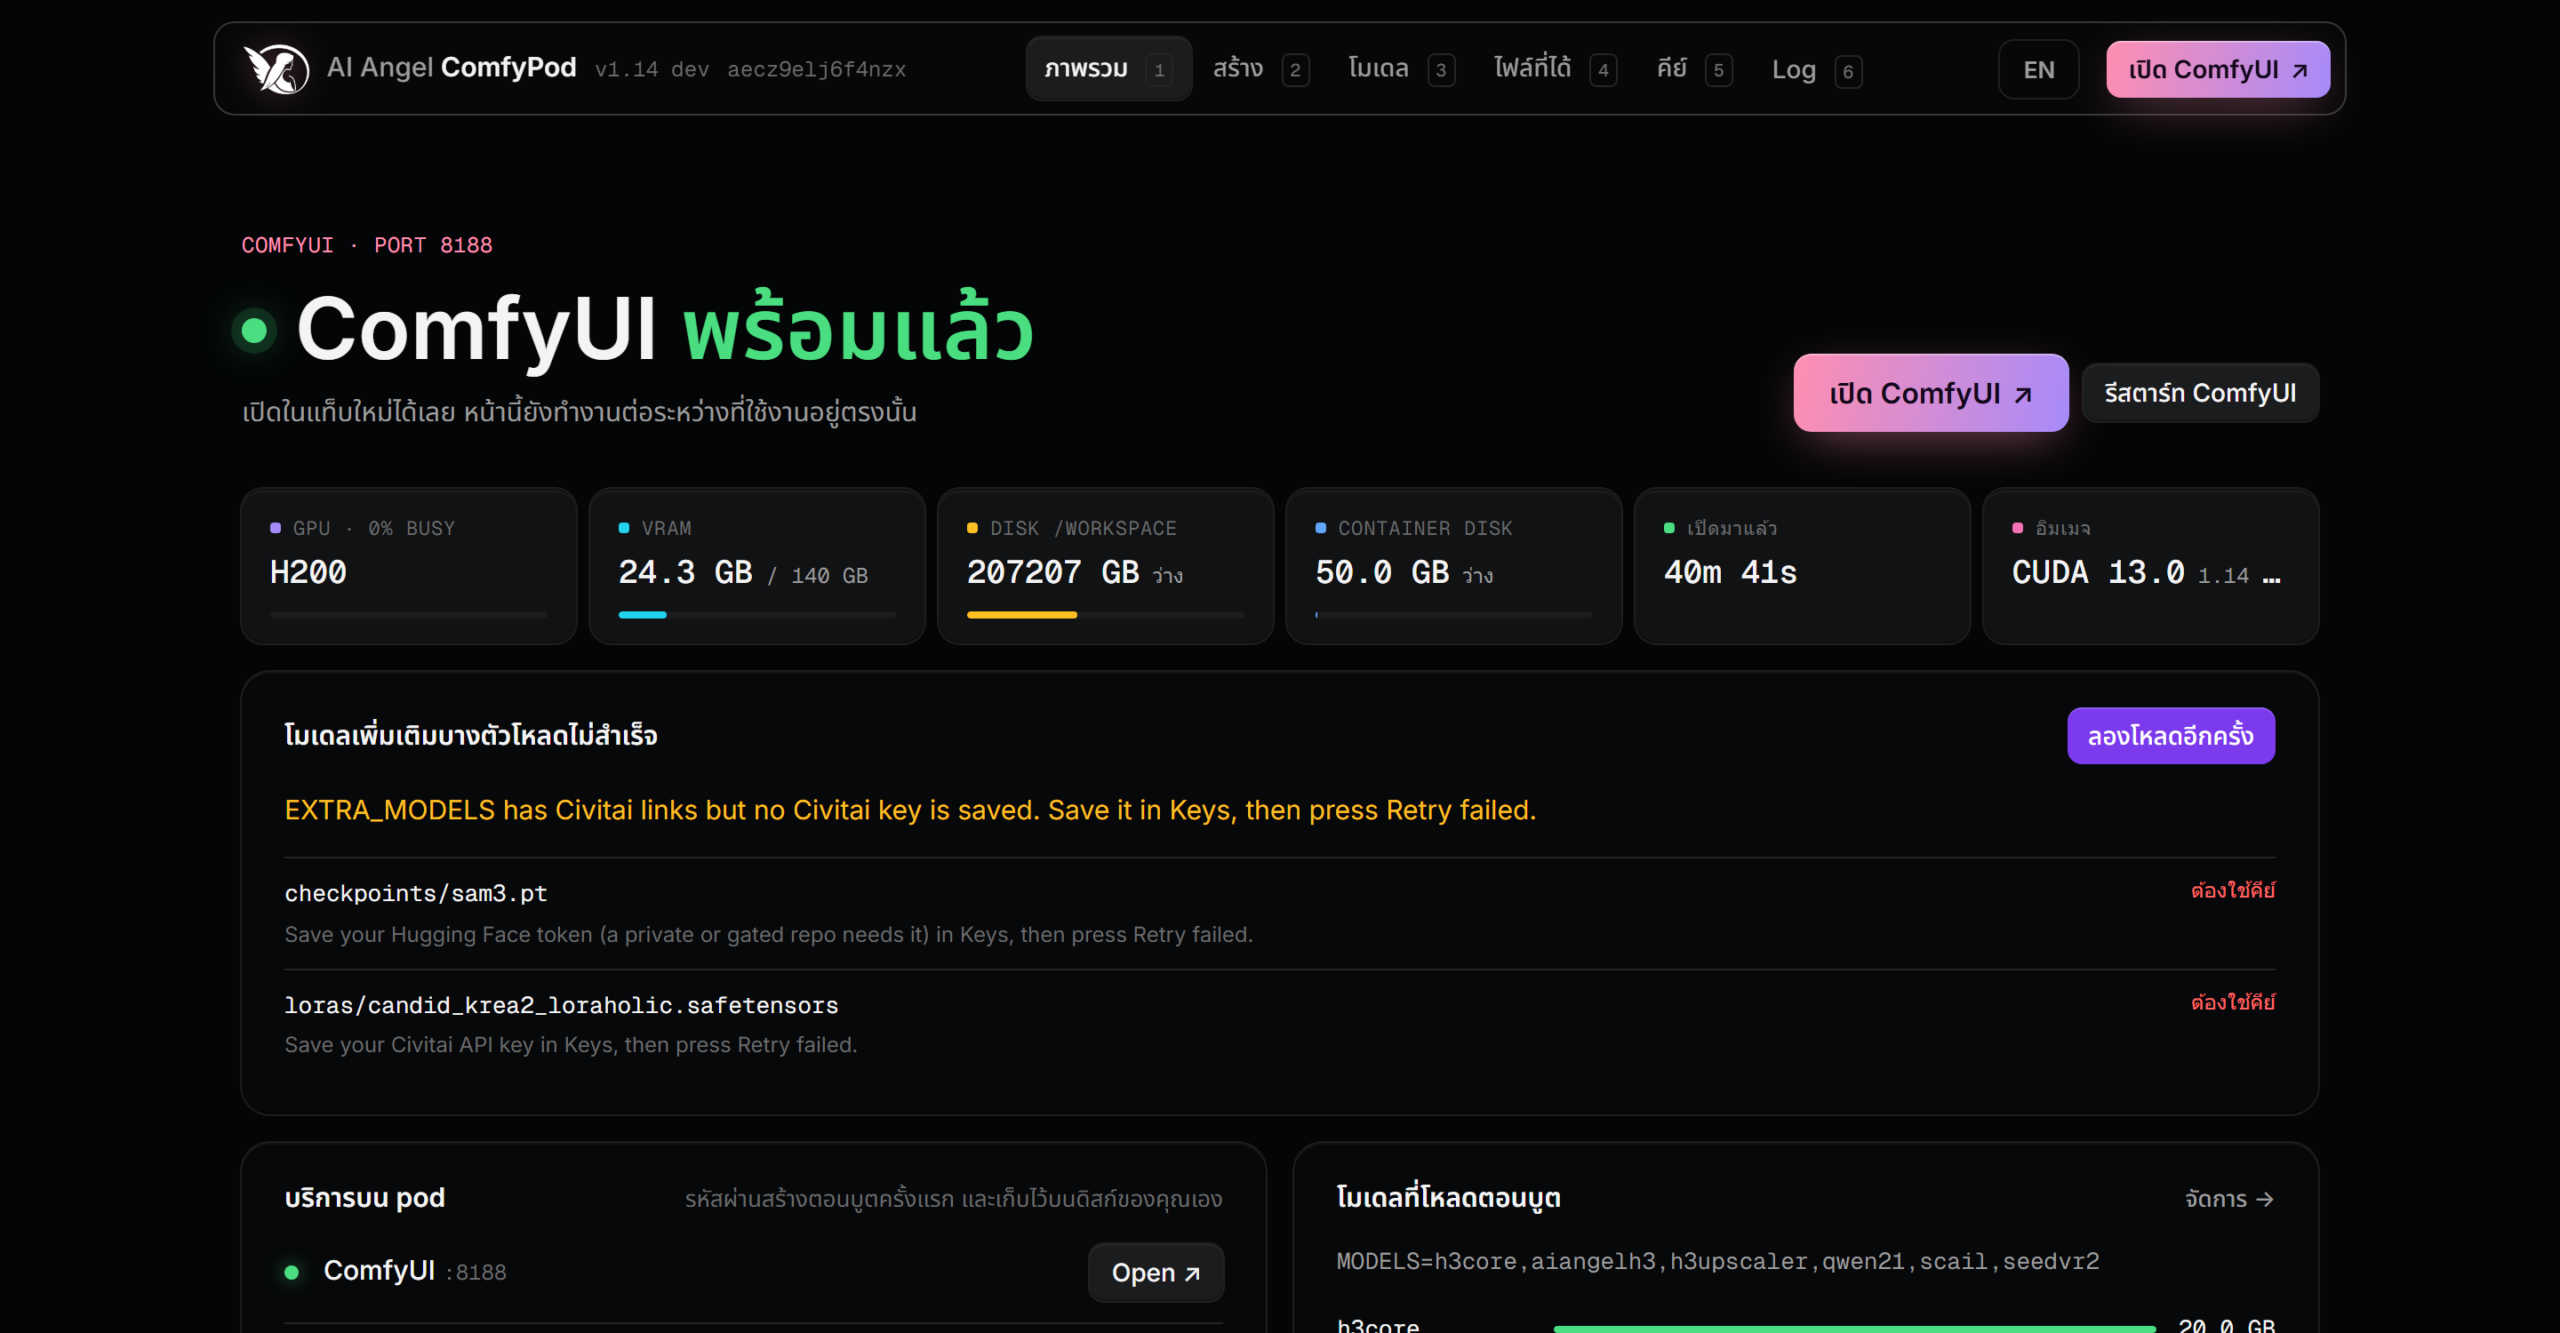
ใส่ลิงก์โมเดลเพิ่มเอง (EXTRA_MODELS หรือแท็บโมเดล) แล้วบางลิงก์โหลดไม่ผ่าน จะมีกล่องแดงในแท็บ ภาพรวม และ โมเดล pod อาจขึ้นว่าพร้อมแล้ว แต่โมเดลตัวนั้นไม่มา
- ดูป้ายแต่ละแถว ต้องใช้คีย์ หรือ ไม่สำเร็จ
- ต้องใช้คีย์: Civitai ใช้ API key ของ Civitai · Hugging Face ส่วนตัวหรือต้องขอสิทธิ์ใช้ token
- ไปแท็บ คีย์ บันทึกคีย์ที่ถูก ไฟล์ที่ค้างจะโหลดใหม่เอง
- หรือกด ลองโหลดอีกครั้ง มุมขวาบนกล่อง ดูผลในการ์ด รายการดาวน์โหลด
- ไม่สำเร็จ: กลับไปเช็กลิงก์ว่าถูกไหม
ยังไม่ใส่คีย์ กดลองใหม่กี่รอบก็ไม่ผ่าน ทุกไฟล์ผ่านหมด กล่องแดงหายเอง
คลิปแรกทำไมนานมาก ค้างหรือเปล่า
รัน workflow แล้ว error ว่าหาไฟล์โมเดลไม่เจอหรือไฟล์เสีย
ไฟล์โมเดลกับผลงานเก็บอยู่ตรงไหน
/workspace เปิดดูผ่าน FileBrowser (พอร์ต 8080) ได้ user คือ admin รหัสผ่านดูในหน้า ภาพรวมกด Stop แล้วไม่เสียเงินแล้วใช่ไหม
พิมพ์ภาษาไทยได้ไหม
โหลด LoRA แล้วไม่โผล่ในช่องเลือก
ใช้ RTX 5090 แทน RTX PRO 6000 ได้ไหม
ส่งลิงก์ Dashboard ให้เพื่อนได้ไหม
เจอปัญหาแล้วจะแจ้งที่ไหน
AI Angel ComfyPod เป็นแค่ template ติดตั้ง ComfyUI โหลด node กับโมเดลให้ครบ แล้วรันตาม prompt กับรูปที่ผู้ใช้ใส่ ไม่ได้คิด prompt ไม่ได้เลือกรูป และไม่ได้ตรวจว่าผลที่ออกมาเหมาะสมหรือไม่
บทนี้ยังไม่ได้ย้ายมาใน mockup
ตอนทำจริง เนื้อหาเดิมจากหน้าคู่มือจะมาอยู่ตรงนี้ พร้อมลูกเล่นของบทนี้เอง